
Préambule
Une fois n’est pas coutume, j’aimerais comme d’habitude raconter brièvement comment j’ai été amené à m’intéresser au sujet de cet article.
Une journée comme une autre. Je m’apprête à me coucher quand j’entends un léger bruit aigu.
Je cherche pendant un moment d’où vient ce bruit. N’en trouvant pas la source, je décide alors de mettre des bouchons d’oreilles avant de me mettre au lit.
Ce à quoi je ne m’attendais pas, c’est qu’au lieu de diminuer, le bruit a augmenté. C’est alors que je réalise quelque chose : le bruit est dans ma tête.
J’ai depuis maintenant deux ans ce qu’on appelle un acouphène persistant.
Les acouphènes
Bien que ça ne soit pas le sujet principal de cet article, attardons-nous un peu sur les acouphènes.
Définition Ameli : Les acouphènes sont des bruits (sifflements, bourdonnements, grésillements, etc.) que l’on entend dans une oreille (ou les deux) ou dans sa tête sans qu’ils aient été émis par une source du monde extérieur. Ces symptômes sont souvent liés à un traumatisme acoustique ou au vieillissement de l’oreille.
La plupart des gens en ont déjà expérimenté un au moins une fois. Il est dans la très grande majorité des cas passager.
Cependant, il peut arriver qu’il devienne permanent.
C’est souvent le cas lors d’une exposition prolongée à un son trop puissant sans protection, mais il peut aussi apparaître spontanément du jour au lendemain (c’est mon cas).
Dans 95% des cas, le son de l’acouphène n’est pas issu d’une source extérieure, il est uniquement perçu par le cerveau. On parle alors d’acouphène subjectif.
Dans les 5% restants, on dit qu’il est objectif : il y a bel et bien une source physique au son entendu.
Ce son peut prendre différentes formes, la plus courante étant une sorte de sifflement, bien que ça puisse être des bourdonnements, chuintements, grésillements ou encore d’autres perceptions.
Si vous vous demandez à quoi un acouphène de type sifflement ressemble, on peut aisément le reproduire via n’importe quel générateur de tonalité comme celui-ci. La gamme se situe alors généralement entre 3 000 Hz et 8 000 Hz, bien que ça puisse varier (le mien est à 1 315 Hz par exemple).
C’est encore à ce jour incurable, et un acouphène permanent est très généralement à vie.
Je vous redirige vers l’excellent article d’Ameli si vous voulez approfondir.
Si je vous raconte tout ça, c’est parce que de mon côté, quand ça m’est arrivé, le premier mois a été dur. Plus je me concentrais dessus, plus je l’entendais fort. Ça s’est révélé particulièrement insupportable la nuit lorsque j’essayais de trouver le sommeil.
Après plusieurs insomnies et quelques heures de recherches sur la pathologie, je découvre le concept de “bruit blanc”, une sorte de bruit qui selon les dires serait apaisant et annulerait l’acouphène.
Un bruit blanc, donc. Intéressant.
Bruits blancs (mais pas que)
Je tape alors “White Noise” sur Google, et le premier lien qui m’est renvoyé est cette vidéo YouTube. Un bruit blanc de 10 heures. 342M de vues pour un simple bruit, ça a de quoi intriguer.
Mon acouphène n’étant situé que sur une seule oreille, je mets un écouteur dessus, son au minimum dans le silence complet, et c’est effectivement assez bluffant : je n’entends que ce bruit blanc, mais plus mon acouphène.
Note : Ce n’est que plus tard que je découvrirai que le son dont je parle n’est pas réellement un bruit blanc, mais plutôt une de ses variantes, que l’on appelle le bruit rose. Les variantes du bruit blanc sont souvent appelées “bruit blanc” par abus de langage.
J’essaie alors de comprendre le fonctionnement de ce fameux bruit, je recherche toutes les informations possibles, je pose même la question à mon ORL. La réponse est moins technique qu’il n’y paraît : si le son vient de notre cerveau, tous les moyens sont bons pour le distraire avec une réelle source sonore. C’est tout.
À noter qu’à l’heure actuelle, l’acouphène est encore très peu compris par la médecine, la plupart des explications en sont encore au stade de théories.
Mais si on suit cette logique, le “bruit blanc” n’est en fait rien d’autre qu’un son qui a la qualité de distraire mon cerveau, qui ne se préoccupe plus de l’acouphène pour se focaliser dessus. Ce bruit étant à la fois étrangement aléatoire et stable, il permet de générer une sorte de “bruit de fond” tel que le ferait un ventilateur ou une pluie extérieure.
Je n’utilise pas ces termes au hasard, c’est souvent à ça que sont comparées ces variantes de bruit blanc (on parle parfois aussi d’une mer lointaine).
La particularité de ce bruit, c’est qu’il est suffisamment présent pour distraire notre cerveau de certaines fréquences parasites (comme un acouphène), mais il est suffisamment neutre pour que notre cerveau finisse par l’oublier. En ne faisant ainsi plus attention à un bruit qui masque naturellement l’acouphène, on obtient alors un moyen de créer virtuellement du silence.
La première fois que je l’ai essayé, j’ai été bluffé par son efficacité. C’est alors la première fois depuis l’apparition de mon acouphène que j’ai pu retrouver correctement le sommeil.
C’est décidé : je veux comprendre comment ça marche. Je sais écrire des algorithmes, il n’y a pas de raison que je ne sache pas générer ces fameux bruits.
Mais avant ça, il est nécessaire de faire un point sur le fonctionnement du son.
Note : À cet instant de mon voyage, je ne suis pas encore conscient de la nature réelle du bruit que je viens d’écouter. Puisque tout le monde semble appeler ça du bruit blanc, ma quête sera donc de créer du bruit blanc.
Amplitude et fréquence
Le son est la manifestation d’une onde acoustique.
Quand nous écoutons du son, ce que nous entendons, ce sont des variations de pression de l’air.
L’onde sonore fait pousser et tirer l’air autour de nous très rapidement. On parle de pression positive ou négative.
Ces mouvements de l’air se caractérisent par deux éléments fondamentaux qui définissent tout ce que nous percevons : l’amplitude et la fréquence.
L’amplitude représente l’intensité de la variation de pression. C’est par exemple la distance maximale parcourue par la membrane d’un haut-parleur lorsqu’elle avance ou recule. C’est la force de l’onde sonore.
Plus l’amplitude est grande, plus le son est fort.
La fréquence représente le nombre de cycles complets comprenant une pression positive et une pression négative par seconde. C’est la vitesse de vibration (oscillation) de l’onde sonore.
Plus la fréquence est élevée, plus le son est aigu.
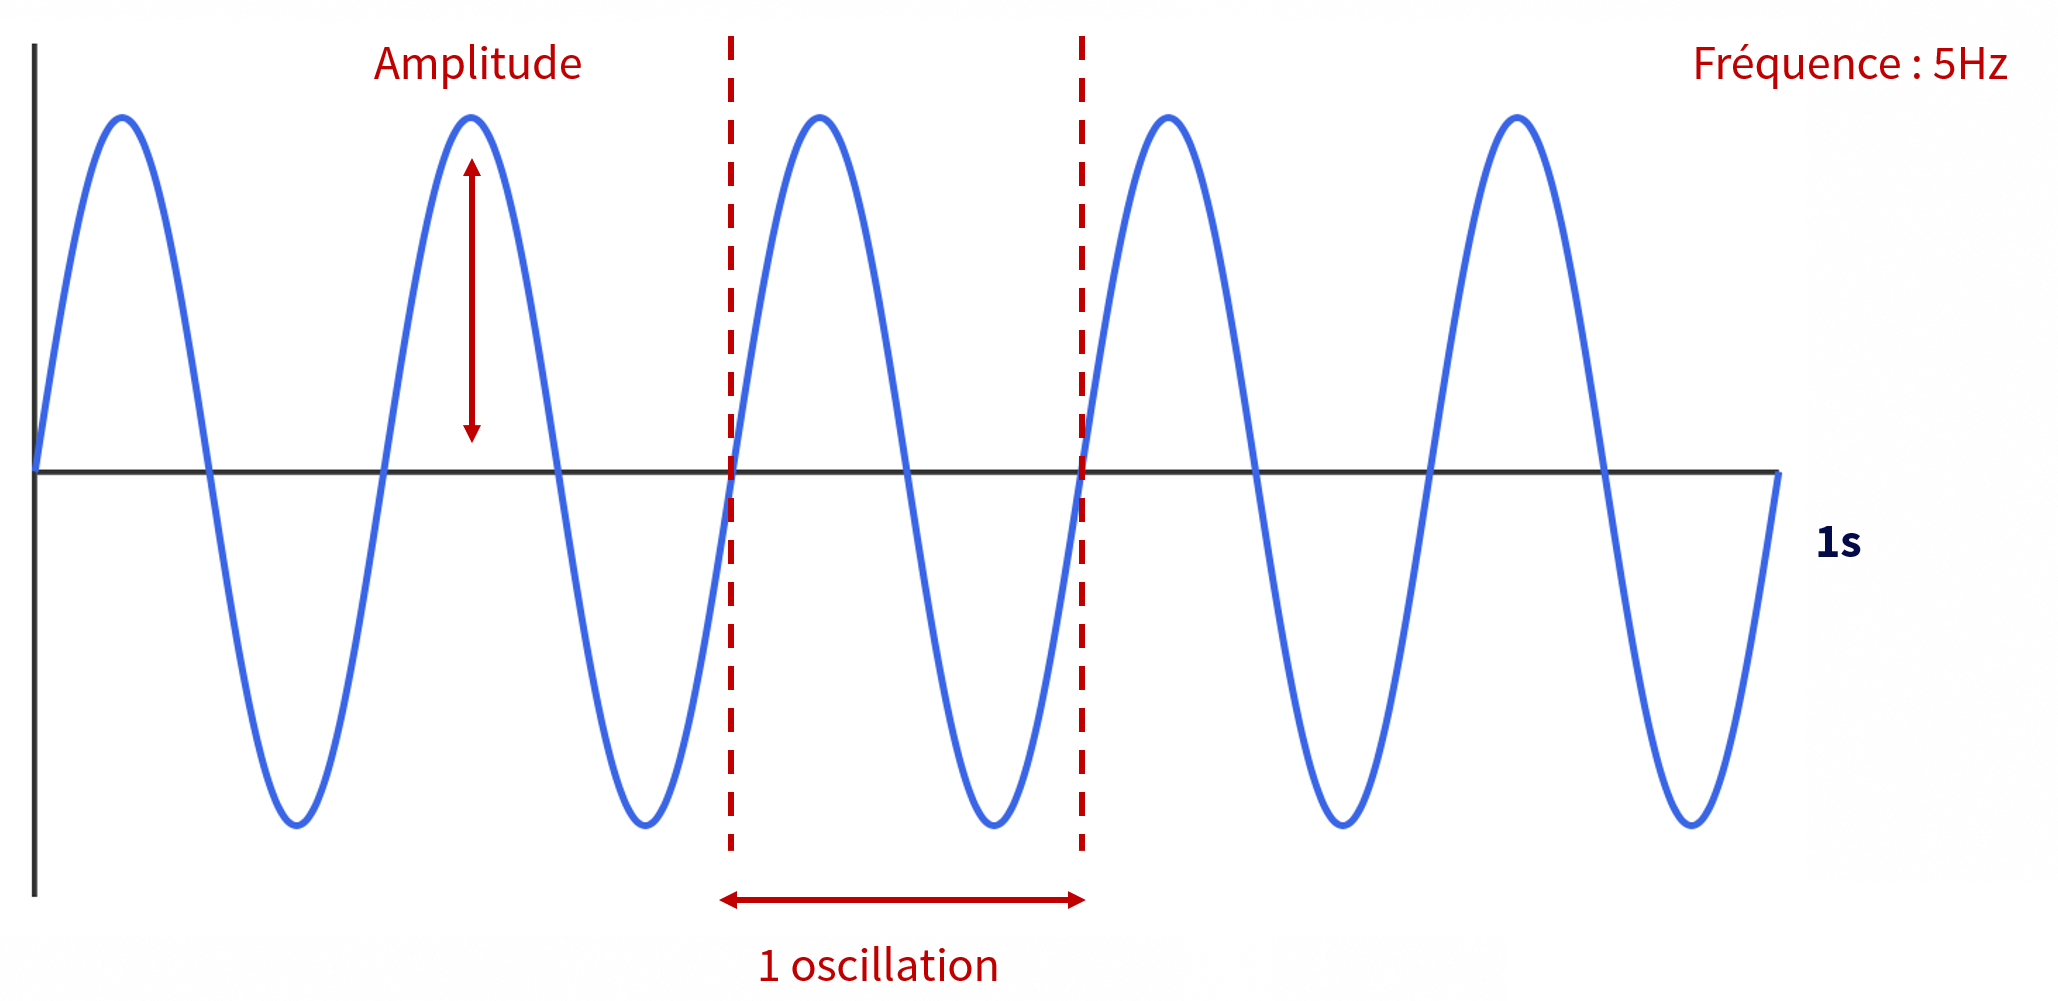
Lorsqu’un son ne contient qu’une seule fréquence sinusoïdale, on parle d’un son pur. C’est à ce genre de son que ressemblent justement les acouphènes de type sifflement.
C’est également ce type de son que vous entendez lorsque vous frappez un diapason ou lorsque vous écoutez la tonalité des téléphones quand vous essayez d’appeler quelqu’un (c’est aussi en France le même son continu qu’on entend sur les téléphones fixes).
Ces sons ont d’ailleurs la même fréquence : il s’agit du La (plus précisément du La4 en notation internationale, soit le La3 en notation française). La fréquence de ce La a été historiquement fixée à 440 Hz en 1939 pour des raisons de standardisation mondiale, il est aujourd’hui utilisé comme fréquence de référence par défaut pour accorder les instruments et étudier le son.
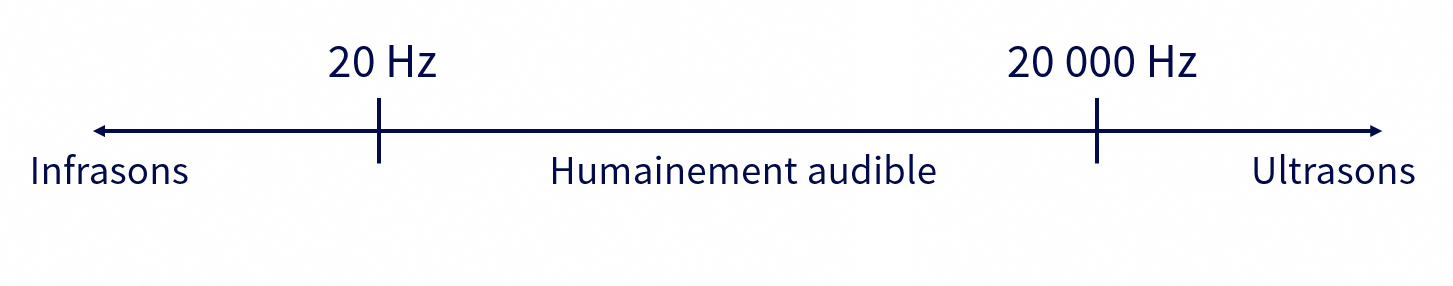
En tant qu’humains, nous sommes capables de percevoir des sons dont la fréquence se situe entre 20 Hz et 20 000 Hz (20 kHz).
En dessous de 20 Hz, ce sont des infrasons, et au-dessus de 20 kHz, ce sont des ultrasons. Ces sons ne sont pas audibles par l’homme.
Okay, là ça commence à me parler un peu plus, mais moi, ce qui m’intéresse, c’est comment produire du son par informatique.
Pour produire / stocker une image, je vois bien : on prend des pixels colorés, on en met plein en matrice, et ça fait une image.
Mais pour le son, ça marche comment ?
Échantillonnage
C’est en me posant cette question que j’ai commencé à me frotter à l’échantillonnage. C’est la base absolue de toute production de son en informatique.
En réalité, l’échantillonnage n’est pas né avec l’informatique moderne. C’est un principe fondamental de traitement du signal utilisé en physique depuis bien longtemps. Le but est de transformer un phénomène continu (qui évolue sans interruption, comme la température, le vent ou le son) en une série de valeurs discrètes (des nombres isolés).
La raison est simple : on ne peut pas stocker l’infini en mémoire. Donc on le découpe pour pouvoir l’enregistrer, l’analyser et le manipuler (ici, ce sera dans notre code).
L’échantillonnage consiste à enregistrer l’amplitude de l’onde sonore à des intervalles de temps extrêmement courts et réguliers. L’ordinateur va noter la valeur de la pression à chaque instant T, et il va faire ça des milliers de fois par seconde.
Prenons le cinéma. Dans la vraie vie, le mouvement est continu. Mais une caméra se contente de capturer 24 images par seconde pour le recréer sur un écran.
Pour le son, c’est exactement la même logique, on va juste beaucoup plus vite.
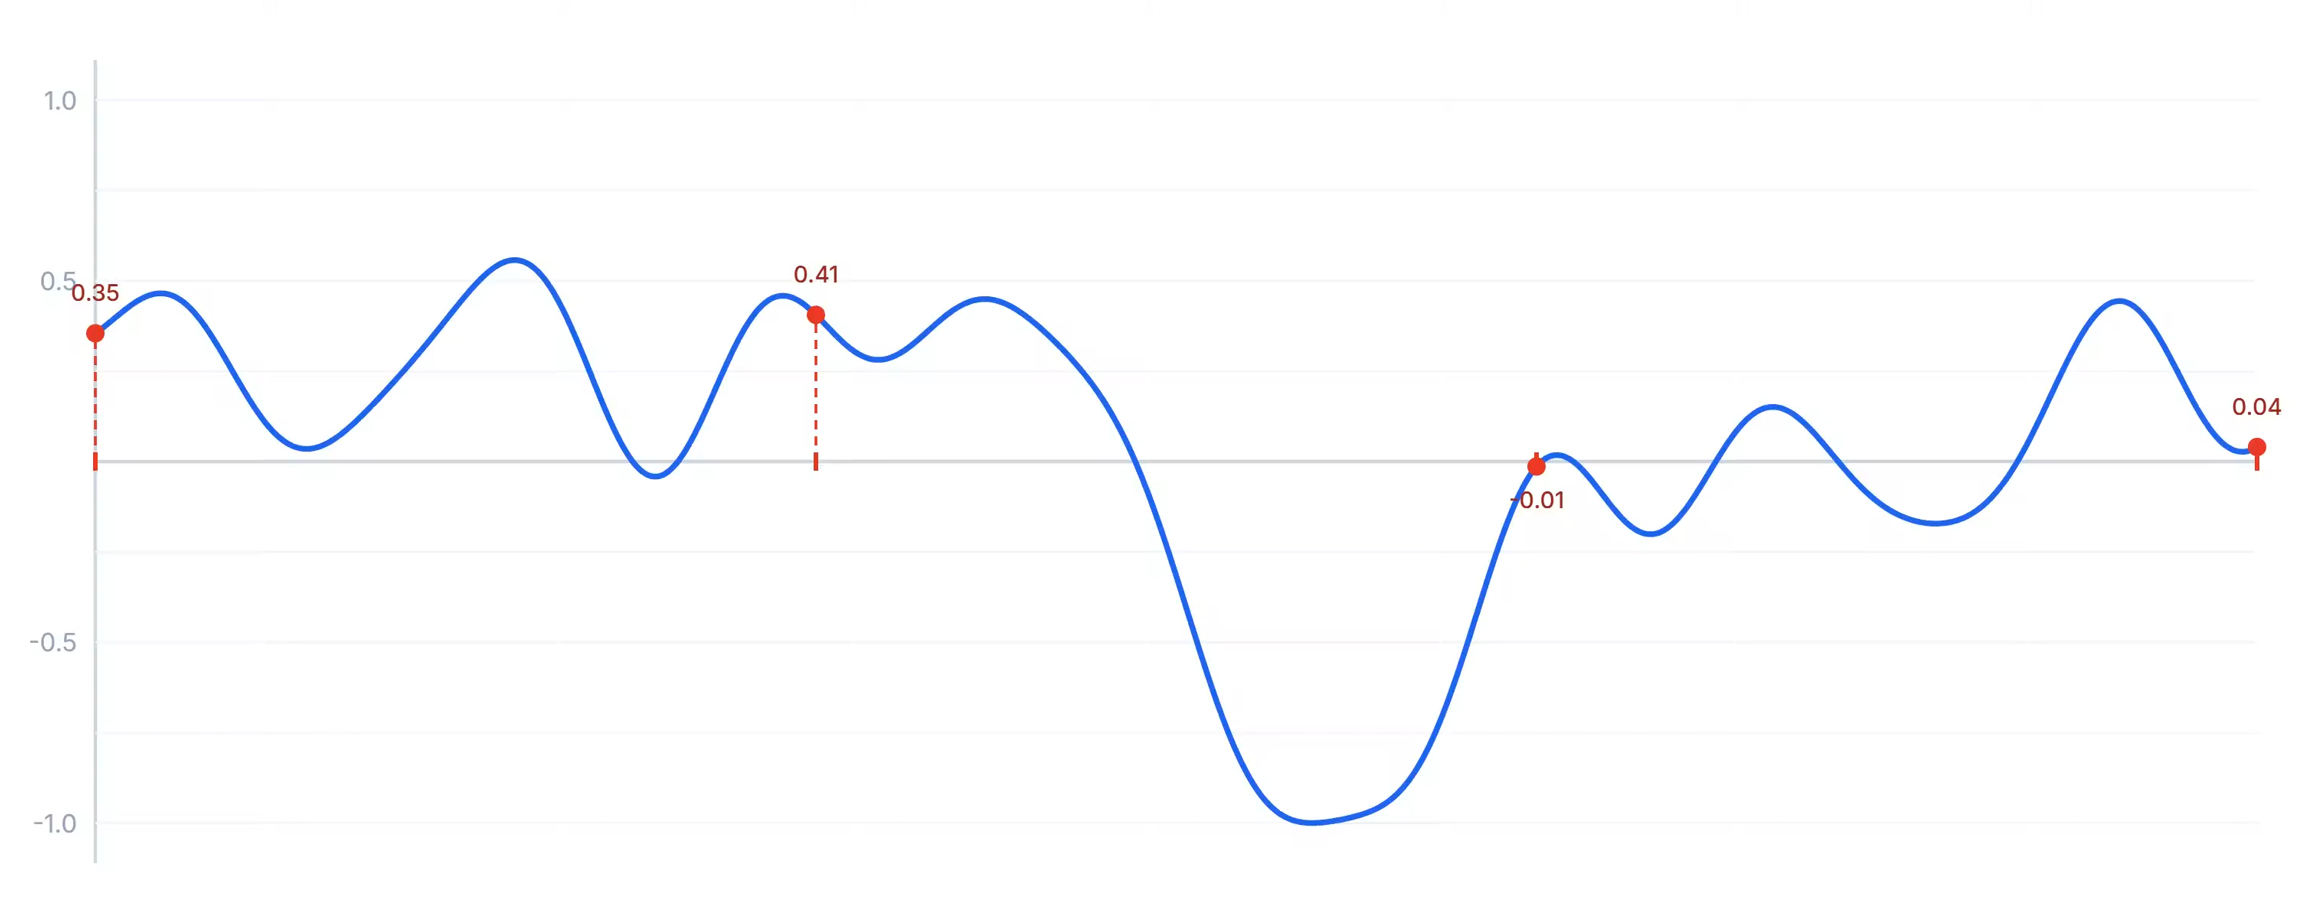
Dans cet exemple, nous enregistrons 4 fois l’amplitude à intervalles réguliers sur le signal. Ce sont donc 4 informations tirées directement du signal, et elles sont numériques : ça signifie qu’on va pouvoir les stocker et les traiter par ordinateur.
Le truc, c’est que 4 informations, c’est bien trop peu pour qu’on en fasse quoi que ce soit. L’idée va alors être d’augmenter la fréquence d’échantillonnage jusqu’à ce qu’on puisse reproduire fidèlement le signal, rien qu’avec des valeurs numériques.
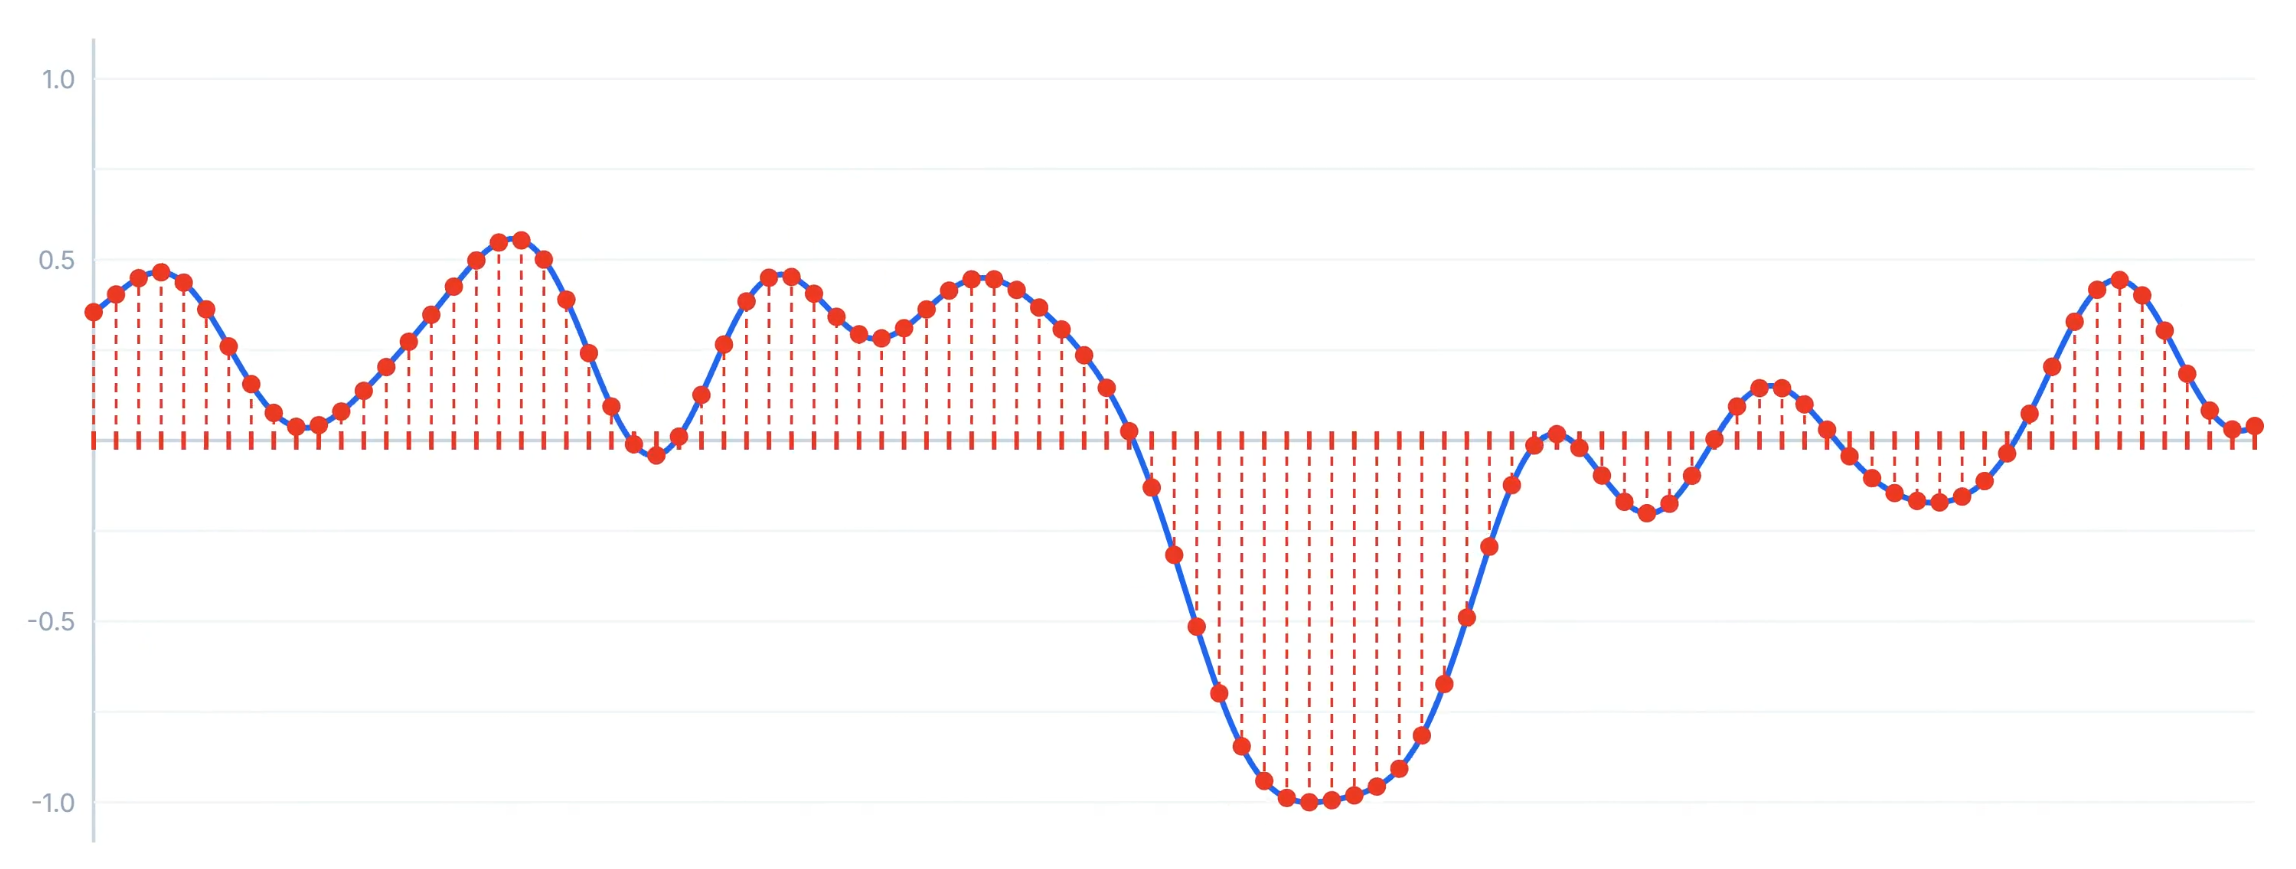
C’est bien mieux !
Une question se pose alors : nous n’allons pas enregistrer une infinité d’amplitudes, donc combien d’échantillons doit-on enregistrer par seconde pour le signal que nous voulons créer ?
Si on prend l’exemple d’un fichier audio standard, on utilise une fréquence d’échantillonnage de 44 100 Hz. Cela signifie que pour chaque seconde de son, l’ordinateur enregistre très exactement 44 100 valeurs mathématiques représentant la pression de l’air. Mises bout à bout et lues à la bonne vitesse, ces données recréent l’onde sonore continue à notre oreille.
Il y a plusieurs raisons à ce choix concernant cette fréquence d’échantillonnage. La raison de l’ordre de grandeur choisi est très importante : comme dit précédemment, l’oreille d’un être humain n’est capable de percevoir que les sons dont la fréquence se situe entre 20 Hz et 20 000 Hz.
Selon le théorème d’échantillonnage (ou théorème de Nyquist-Shannon), afin de numériser correctement un signal continu sans perte ni déformation, il faut échantillonner à au moins le double de sa fréquence la plus haute.
La fréquence la plus haute audible par l’humain étant de 20 000 Hz, il faudra alors échantillonner notre signal à au moins 40 000 Hz. Cette valeur a ensuite été portée à 44 100 Hz pour le CD audio, d’abord pour laisser une marge au filtre anti-repliement, puis parce que ce chiffre exact venait du hardware de l’époque : l’audio numérique était alors stocké sur des magnétoscopes, et 44 100 Hz était la cadence compatible avec les formats vidéo PAL et NTSC.
Nous avons enfin les connaissances de base dont nous avons besoin pour générer notre bruit blanc, il est temps d’attaquer le code !
Générons notre premier bruit blanc
Mise en place
Première étape, choisir un langage de programmation.
Après quelques recherches, mon choix s’est porté sur le C++, en utilisant le framework JUCE.
J’ai fait le choix d’utiliser une techno conçue pour développer des outils audio hyper poussés et complexes, juste pour faire joujou avec des bruits. Oui, c’est totalement overkill, mais j’avais envie de m’amuser et de découvrir autre chose.
Ici, je ne compte pas développer le moindre logiciel, juste générer des sons avec certaines fonctionnalités de JUCE.
J’ai conçu mon code de façon à avoir :
- Des petits générateurs de son.
- Un runner, qui prend un de ces générateurs en paramètre pour réellement créer le fichier audio.
L’idée est de factoriser au maximum le code, pour pouvoir bien segmenter en fichiers les différents algorithmes que je serai amené à écrire.
En clair, le générateur de son ne fait que remplir un buffer d’échantillons. Il contient une seule fonction : fillBuffer, qui décrit un algorithme de construction d’échantillonnage.
Le runner, lui, prend l’échantillonnage pour produire le fichier son.
Une fois cette architecture mise en place, je peux me focaliser sur l’écriture des algorithmes de sampling (échantillonnage).
Je ne vais pas m’attarder sur le fonctionnement de cette implémentation car ce n’est pas ce qui nous intéresse ici. Le code source sera donné dans son intégralité plus bas.
Générons du bruit blanc
C’est maintenant qu’on va pouvoir s’amuser !
Nous avons les connaissances et outils de base nécessaires pour créer notre bruit blanc. Maintenant, ce qu’il nous manque, c’est une définition. C’est quoi un bruit blanc ?
Définition Wikipédia : Un bruit blanc est une réalisation d’un processus aléatoire dans lequel la densité spectrale de puissance est la même pour toutes les fréquences de la bande passante.
Cette définition vous paraîtra peut-être complexe, notamment à cause de la notion de densité spectrale de puissance. Cela paraîtra bien plus clair quand nous commencerons à visualiser ce qu’on fait. En attendant, je vous propose de nous focaliser sur la partie aléatoire de cette définition.
Ça signifie en gros qu’on entendra en moyenne toutes les fréquences “en même temps” sur le fichier audio.
Quand j’ai parlé de signal sonore plus haut, j’ai montré un son pur, avec une seule fréquence.
Les sons que nous entendons au quotidien sont composés d’une multitude de fréquences.
Eh oui ! Et le plus beau, c’est qu’il est même assez facile de décomposer clairement les fréquences qui constituent un son, et ce grâce à un outil mathématique bien connu : la transformation de Fourier.
Transformation de Fourier
Le célèbre mathématicien Joseph Fourier a formulé en 1811 l’intégrale de Fourier, qui donne naissance à la transformée de Fourier.
Définition Wikipédia : La transformée de Fourier représente une fonction par la densité spectrale dont elle provient, en tant que moyenne de fonctions trigonométriques de toutes fréquences.
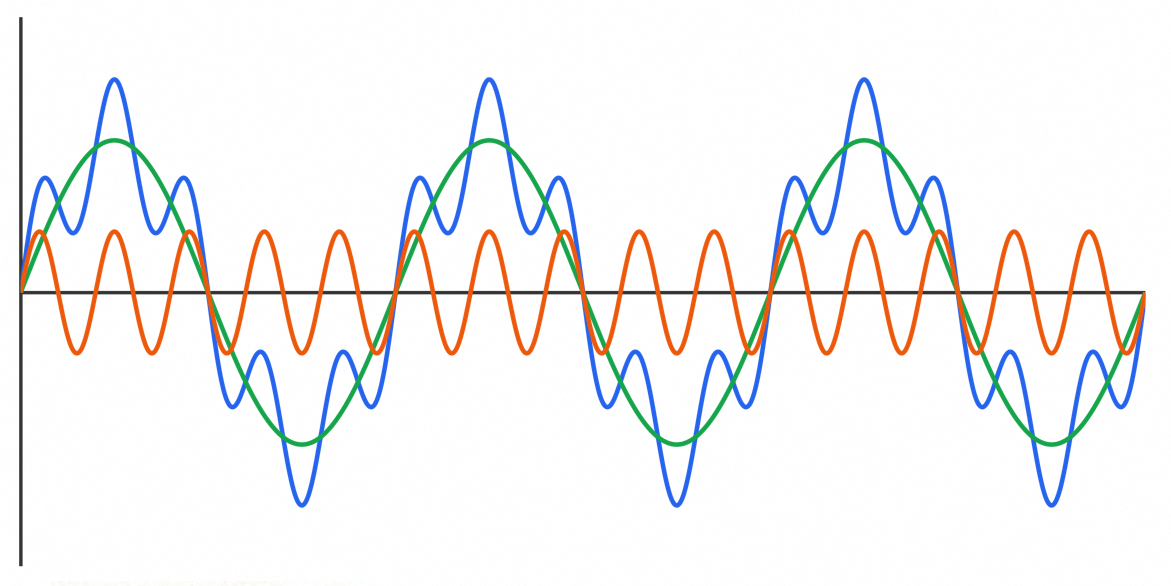
Ça signifie que tout signal (ici acoustique) peut être décomposé en une multitude de sinusoïdes. Donc des fréquences.
Prenons par exemple ce signal relativement simple :
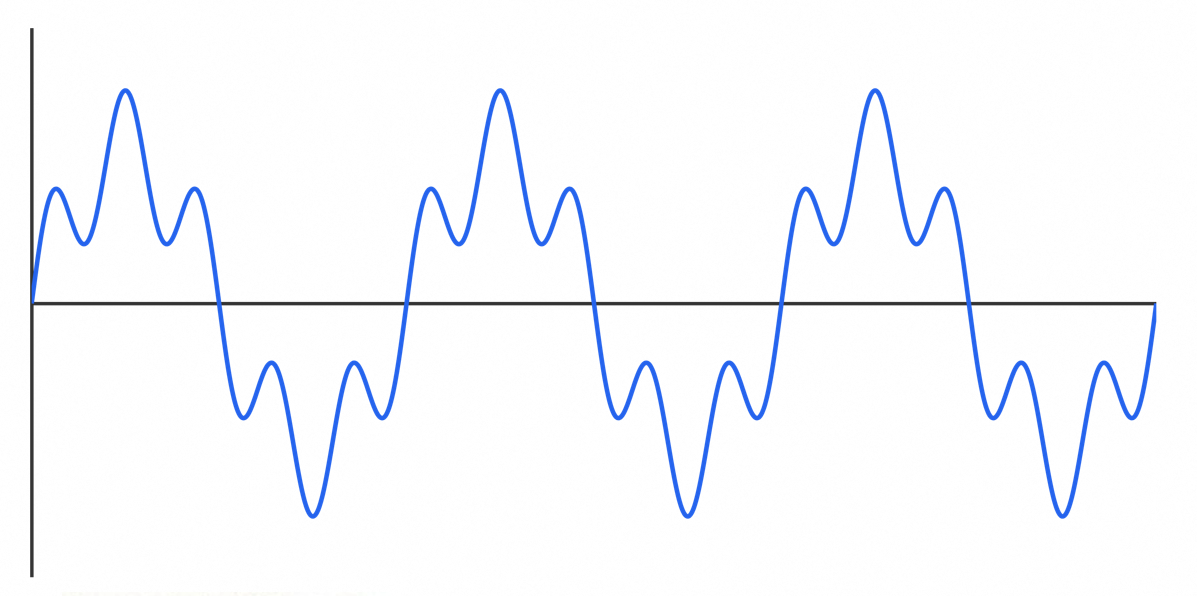
Bien que simple, ce signal n’est pas une sinusoïde. Cela signifie qu’avec la transformation de Fourier, nous pouvons le décomposer en une somme de sinusoïdes. Ici, ce signal est composé de deux sinusoïdes :
Retournons à notre bruit blanc
Peut-être vous interrogez-vous actuellement sur le rapport entre cette parenthèse mathématique et la définition du bruit blanc. J’ai dit juste avant que le bruit blanc était un bruit contenant en moyenne “toutes les fréquences” sur une période de temps donnée. Il trouve qu’en créant un bruit via un signal de la sorte, si on le décomposait avec la transformation de Fourier, on trouverait statistiquement toutes les fréquences de la bande passante à une densité de puissance à peu près égale.
Le signal d’un bruit blanc ressemble à ça :
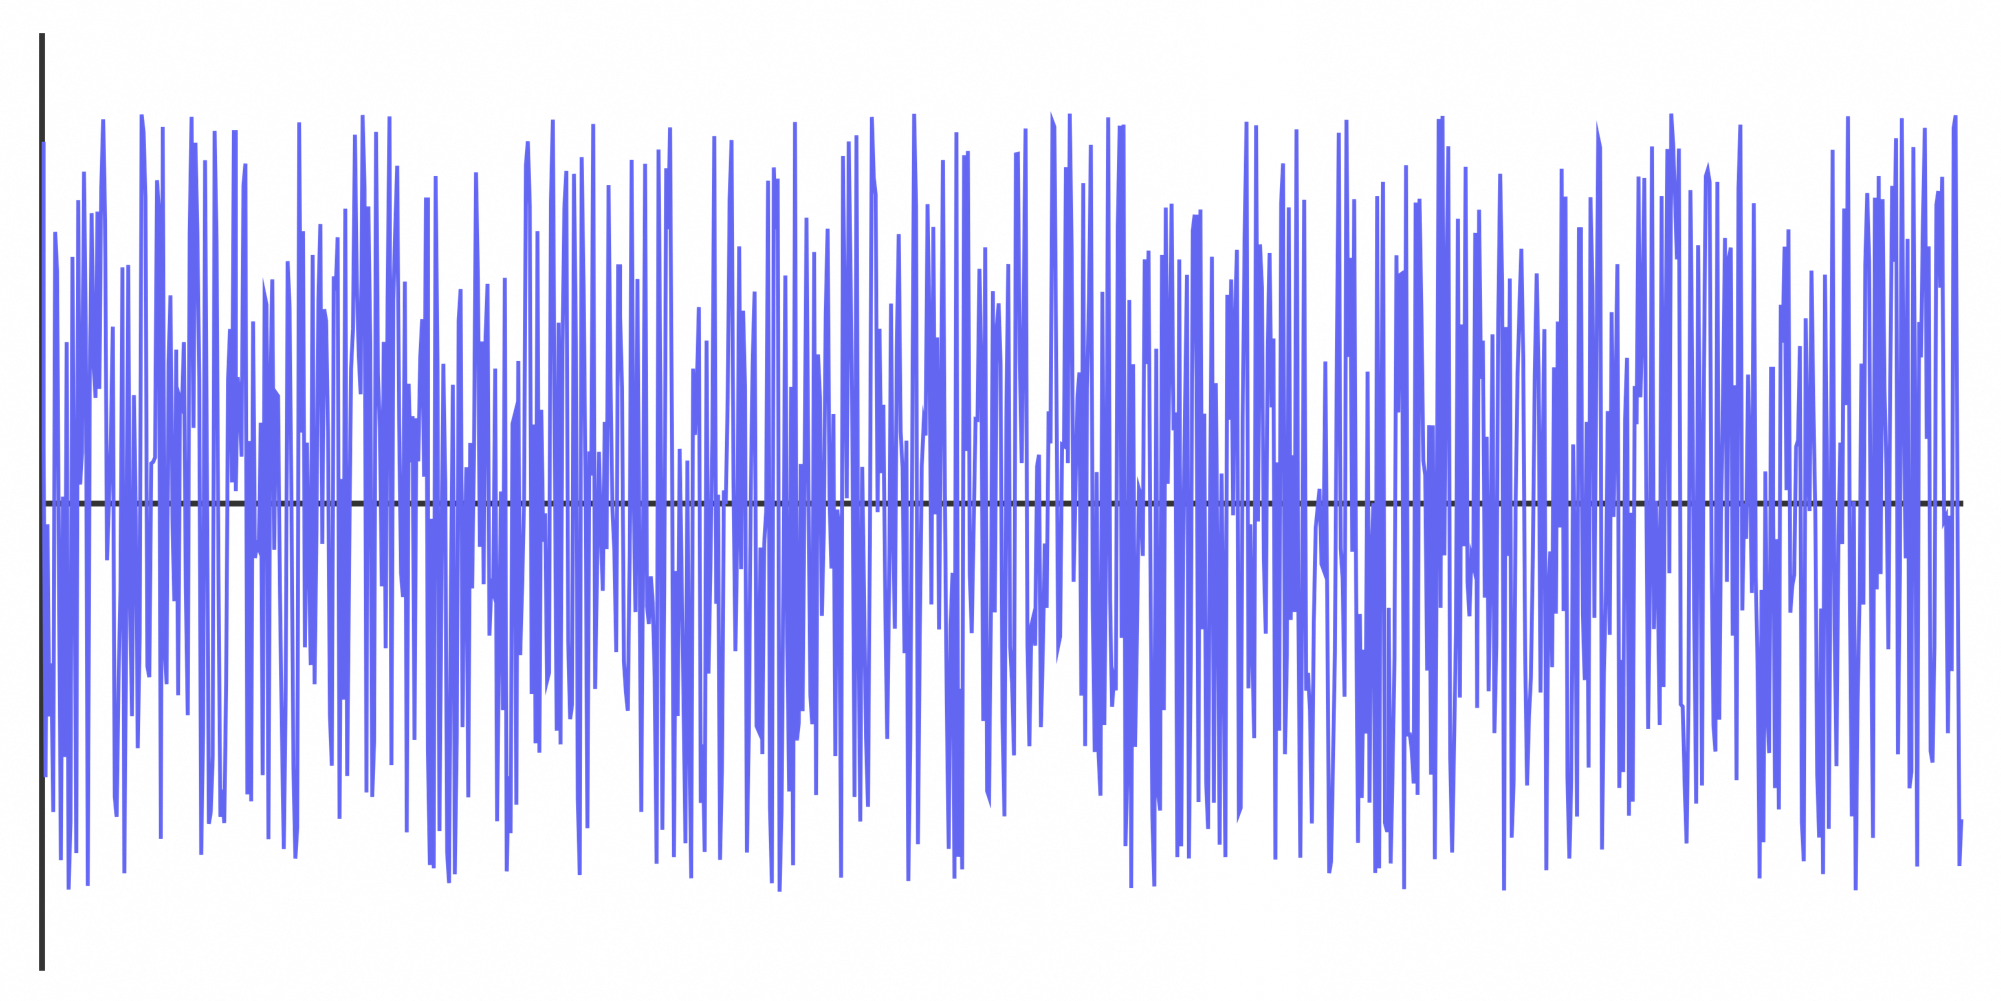
On appelle cette façon de représenter une onde un oscillogramme. Cette représentation est utilisée pour visualiser la forme de l’onde.
Ici, elle est complètement chaotique.
Le bruit blanc est tout simplement le bruit le plus chaotique qui soit. Il est totalement aléatoire. Ce que je veux dire par là, c’est que pour le construire, il suffit de fabriquer un échantillonnage en assignant à chaque échantillon qui le compose une valeur aléatoire.
L’algorithme sera donc très simple :
|
|
Décomposons-le simplement :
numChannelsdécrit le nombre de canaux. 1 pour du son mono, 2 pour du son stéréo. On va donc s’assurer d’écrire dans tous les canaux.numSamplesdécrit le nombre d’échantillons par canal audio. Il est calculé en amont en multipliant la fréquence d’échantillonnage (44 100 Hz) par la durée.
Ensuite, on va “à la main” écrire des valeurs d’amplitude, échantillon par échantillon, jusqu’à remplir tout l’échantillonnage.
Essayer de produire une musique de la sorte n’aurait absolument aucun sens, mais pour générer du bruit qui correspond à un simple algorithme, cette méthode convient parfaitement.
Avec ce qu’on vient d’expliquer, le cœur de l’algorithme permettant de choisir la valeur de chaque échantillon ne tient que sur une seule ligne de code :
|
|
Et c’est tout.
On génère un nombre flottant aléatoire compris entre la valeur maximale négative et positive d’amplitude.
Ici, on remplit donc notre échantillonnage avec des valeurs d’amplitude comprises entre -1 et 1.
Ça va avoir pour conséquence de générer un signal totalement aléatoire, qui correspond parfaitement à la définition du bruit blanc.
Note : On remarque ici qu’on parle d’un aléatoire “pur” (pseudo-aléatoire en pratique, mais ça ne change rien ici), avec des valeurs décorrélées les unes des autres. Aucune valeur n’influe sur la suivante.
On peut alors se demander : pourquoi une variation totalement aléatoire d’amplitude nous permet d’obtenir un bruit qui contient statistiquement toutes les fréquences ?
Tout simplement parce que la fréquence d’une onde est directement corrélée à ses variations d’amplitude.
Prenons le schéma suivant :
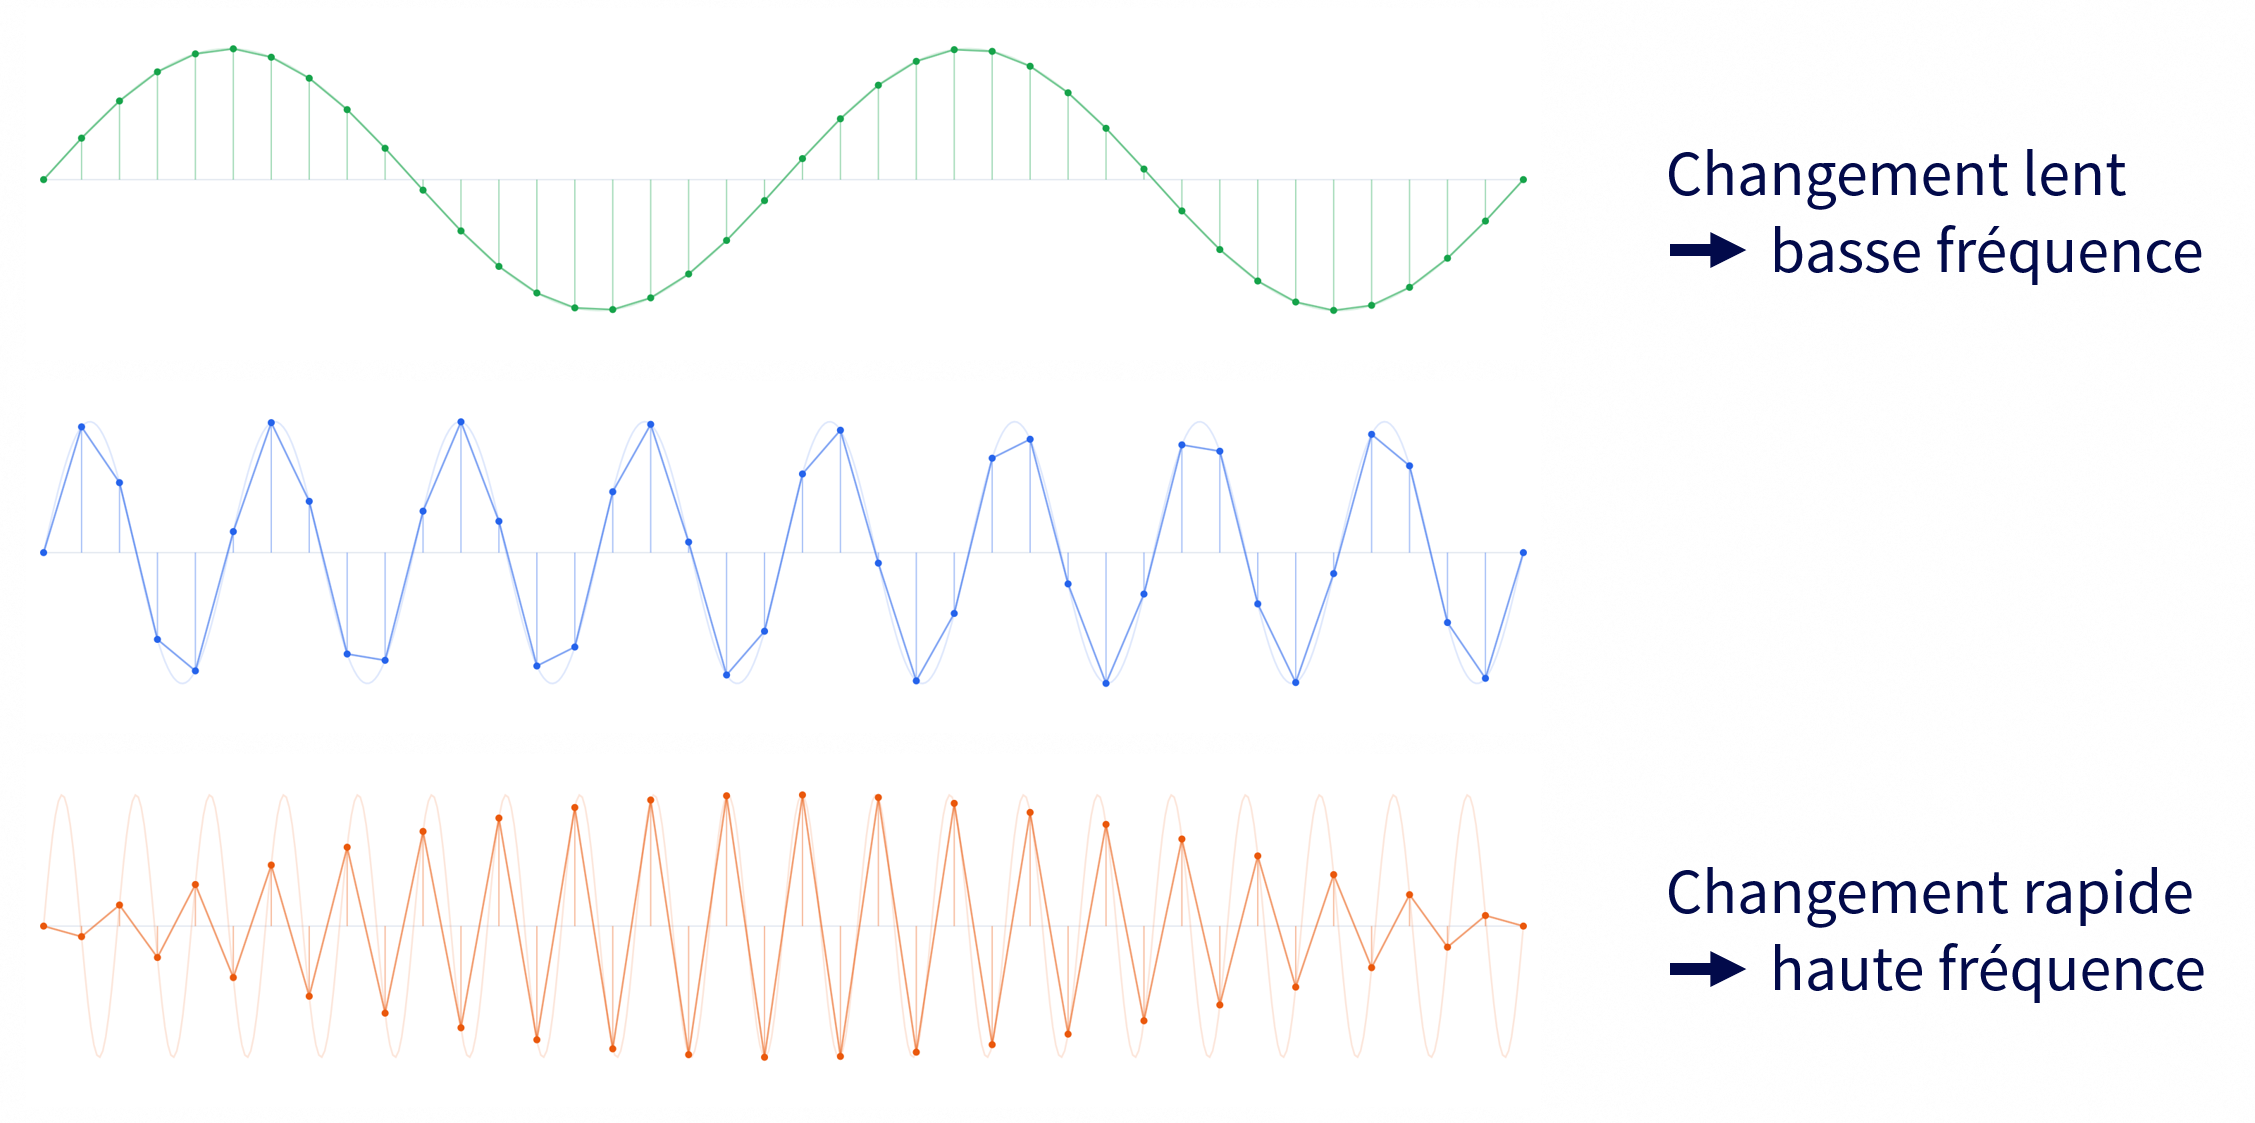
Sur une même échelle de temps, décrire une variation d’amplitude lente nous permettra de reproduire un signal à faible fréquence.
À l’inverse, une variation d’amplitude rapide nous permettra de reproduire un signal à haute fréquence.
Il devient alors plus clair qu’une variation strictement aléatoire d’amplitude à chaque échantillon de notre échantillonnage nous permettra d’obtenir à la fois des fréquences basses et des fréquences hautes.
C’est là toute la magie du bruit blanc : mathématiquement, un signal totalement imprévisible et décorrélé (où chaque échantillon est choisi au hasard sans aucun lien avec le précédent) possède une densité spectrale de puissance constante.
En appliquant la transformation de Fourier à ce signal, on s’aperçoit que l’énergie est répartie de manière parfaitement égale sur tout le spectre, des infra-basses aux ultrasons. Comme aucune fréquence n’est privilégiée par le hasard, elles sont toutes présentes au même niveau “en moyenne”. C’est précisément cette “égalité” fréquentielle qui définit le bruit blanc.
En remplissant notre buffer avec du pur hasard, on a donc généré un signal qui contient statistiquement l’intégralité des fréquences du spectre audible simultanément.
Un bruit blanc, donc.
Passons à l’écoute
Il est temps d’écouter notre bruit blanc !
Baissez le son si vous portez un casque, ça peut être fort et agressif pour les oreilles.
Description du son : un gros PSSSSSSCCCCHHHTT assez agressif qui rappelle le son émis par les anciennes TV cathodiques.
Ah.
Nous sommes loin du son relaxant recherché. Vous comprenez maintenant pourquoi je vous ai dit que le son écouté plus haut n’était pas réellement un bruit blanc, mais plutôt une de ses variantes.
Où me suis-je planté ? Pourquoi ça ne ressemble pas du tout au son de la vidéo que j’ai trouvée sur internet ?
La réponse, c’est que je ne me suis pas trompé sur mon implémentation. La définition du bruit blanc est très simple comme nous l’avons vu, j’avais peu de chances de me tromper là-dessus.
Mon erreur vient de mon incompréhension du cerveau humain, et de la façon dont nous percevons les fréquences.
Notre oreille ne perçoit pas le son de manière linéaire : nous ne percevons pas toutes les fréquences de la même façon.
Notre perception du son est logarithmique.
C’est plus clair si je vous montre ce tableau des octaves :
| Bande (octave) | Fréquence calculée |
|---|---|
| 0 | 31,250 Hz |
| 1 | 62,500 Hz |
| 2 | 125,000 Hz |
| 3 | 250,000 Hz |
| 4 | 500,000 Hz |
| 5 | 1 000,000 Hz |
| 6 | 2 000,000 Hz |
| 7 | 4 000,000 Hz |
| 8 | 8 000,000 Hz |
| 9 | 16 000,000 Hz |
On peut y voir qu’il y a à peu près 30 Hz de différence entre les deux premières octaves, et 8 000 Hz de différence entre les deux dernières.
Ça signifie qu’elle saisit bien mieux les différences entre les fréquences basses qu’entre les fréquences hautes. Passer à l’octave supérieure revient à doubler la fréquence.
Pour notre oreille, le passage de 100 Hz à 200 Hz est un événement majeur (une octave). Le passage de 10 000 Hz à 10 100 Hz, lui, est presque imperceptible. Pourtant, sur un graphique linéaire, ces deux écarts de 100 Hz occupent la même place.
D’où le côté contre-intuitif du bruit blanc.
Une des conséquences, c’est qu’on va davantage percevoir les sons aigus, désagréables et agressifs à l’oreille, parce que chaque octave aiguë contient physiquement beaucoup plus de fréquences (et donc d’énergie) qu’une octave grave. Pour notre oreille, c’est une surcharge : là où une octave basse ne regroupe que quelques dizaines de hertz, une octave aiguë en balance des milliers. C’est cette densité massive d’informations qui crée cette sensation d’agression et de sifflement désagréable.
Ce qui est intéressant avec ce problème, c’est qu’il suffit de le comprendre pour entrevoir la solution.
Mais avant d’aborder cette solution, je pense qu’il est plus que temps que nous commencions à poser des visuels sur ces bruits dont nous parlons.
Ça tombe bien, nous avons vu le principe de la transformation de Fourier, je vais alors pouvoir vous présenter un outil qui s’appuie massivement sur elle : le spectrogramme.
Encore plus visuel : les spectrogrammes
L’idée d’un spectrogramme est de visualiser toutes les fréquences sur un spectre. C’est une sorte de tableau où l’axe Y représente les fréquences (les hautes en haut, les basses en bas), l’axe X représente le temps, et la couleur exprime la puissance du signal sonore.
La puissance est définie par l’intensité de chaque fréquence sur la courte période donnée. On peut donc aisément visualiser les fréquences dominantes du son en temps réel.
Essayons avec un extrait d’une musique pop rock : Miracle de Tip Stevens.
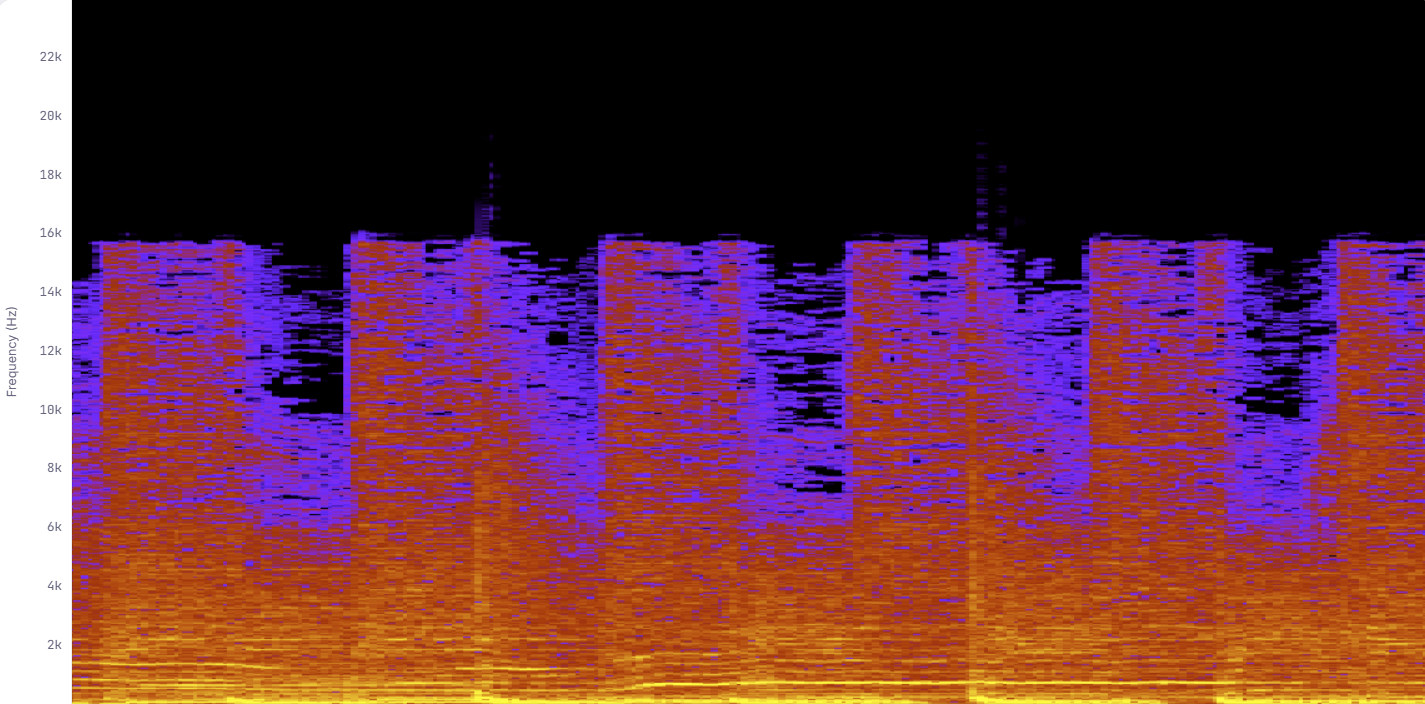
Il y a quelque chose qui cloche avec ce visuel. Il est factuel concernant les fréquences présentes dans le fichier audio, et pourtant, j’ai du mal à être d’accord avec ce que je vois. Toutes les fréquences semblent écrasées vers le bas.
Il faut donc appliquer cette même échelle logarithmique au spectrogramme si l’on veut obtenir un visuel qui correspond à ce que l’on entend réellement :
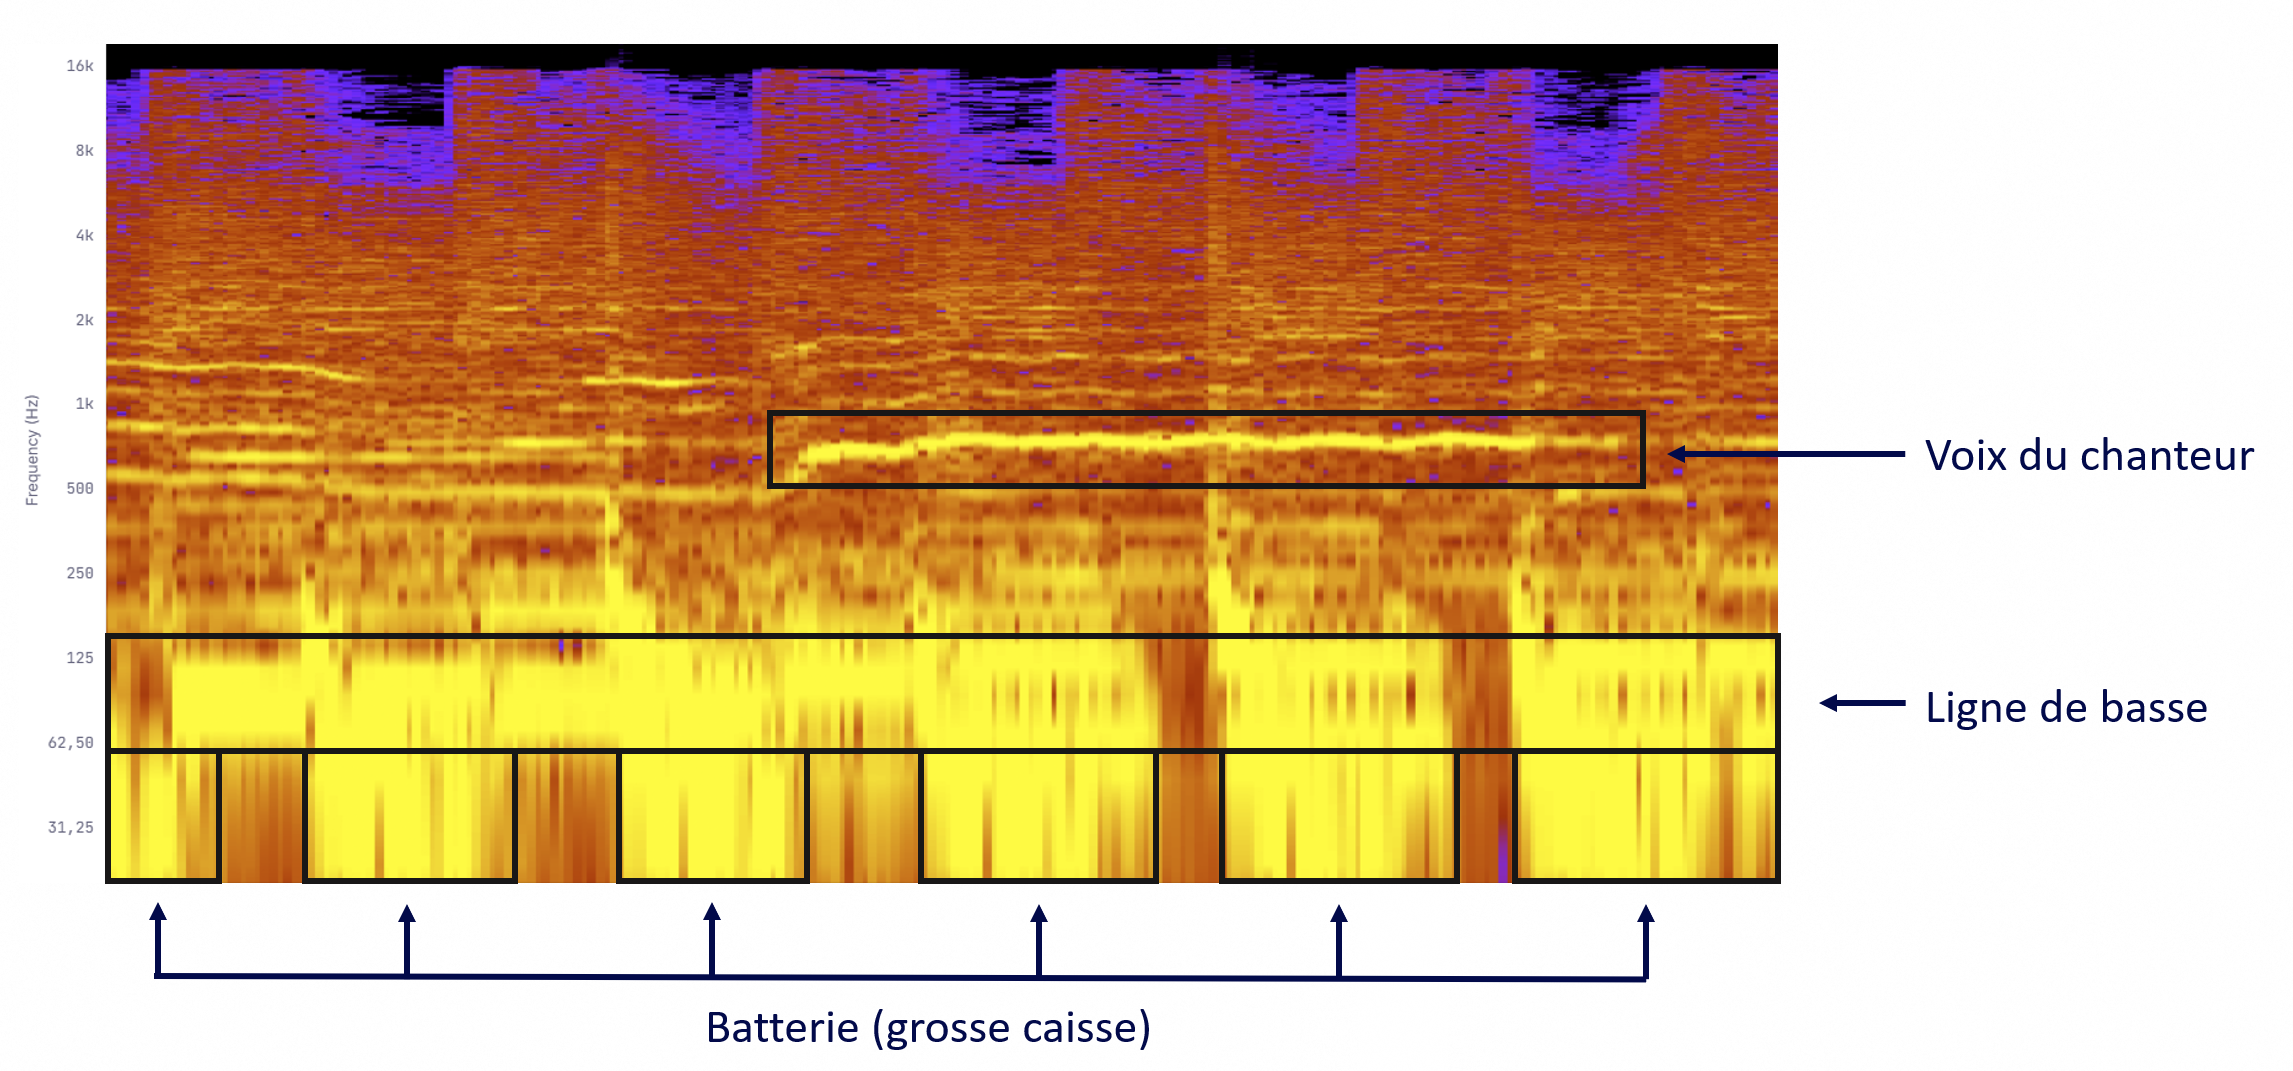
C’est ce qu’on appelle un scaling logarithmique.
Là, c’est déjà plus parlant ! Si l’on écoute la musique en regardant le spectrogramme défiler, on voit alors très bien les fréquences occupées par chaque instrument.
Maintenant que nous venons de voir à quoi ressemble une musique, et si nous essayions de visualiser notre bruit blanc ?
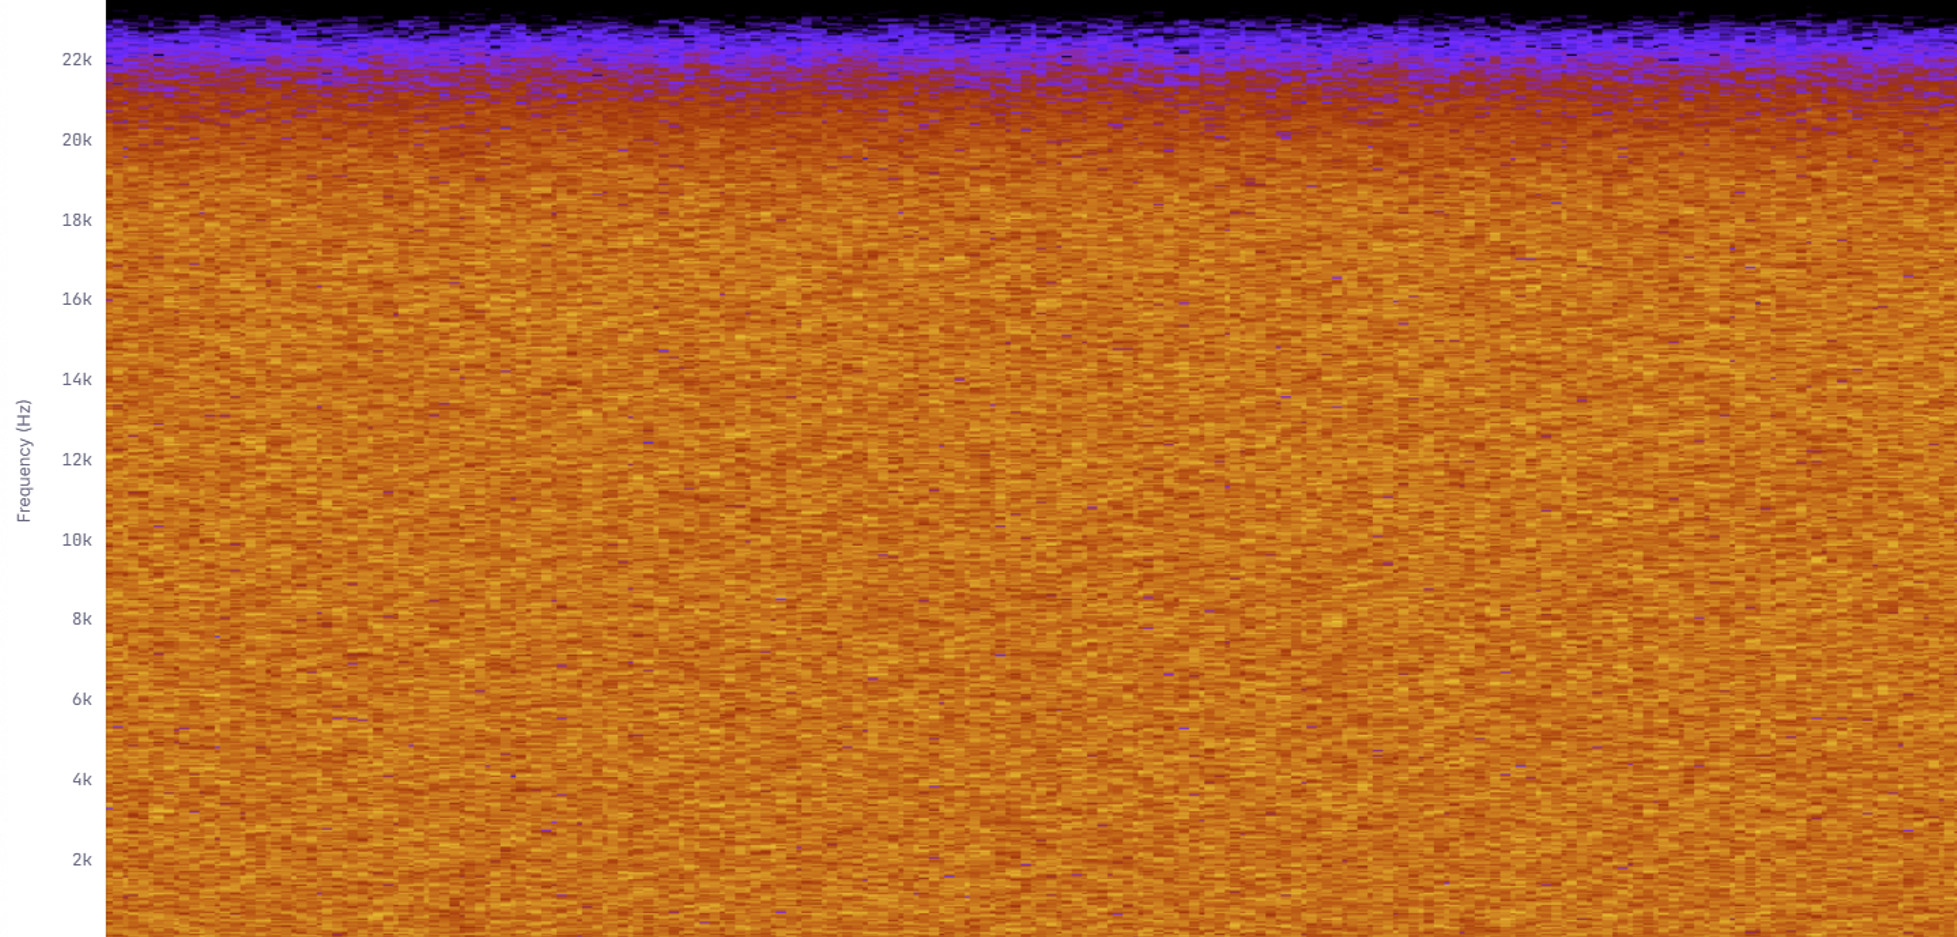
Sans scaling :
Avec scaling logarithmique :
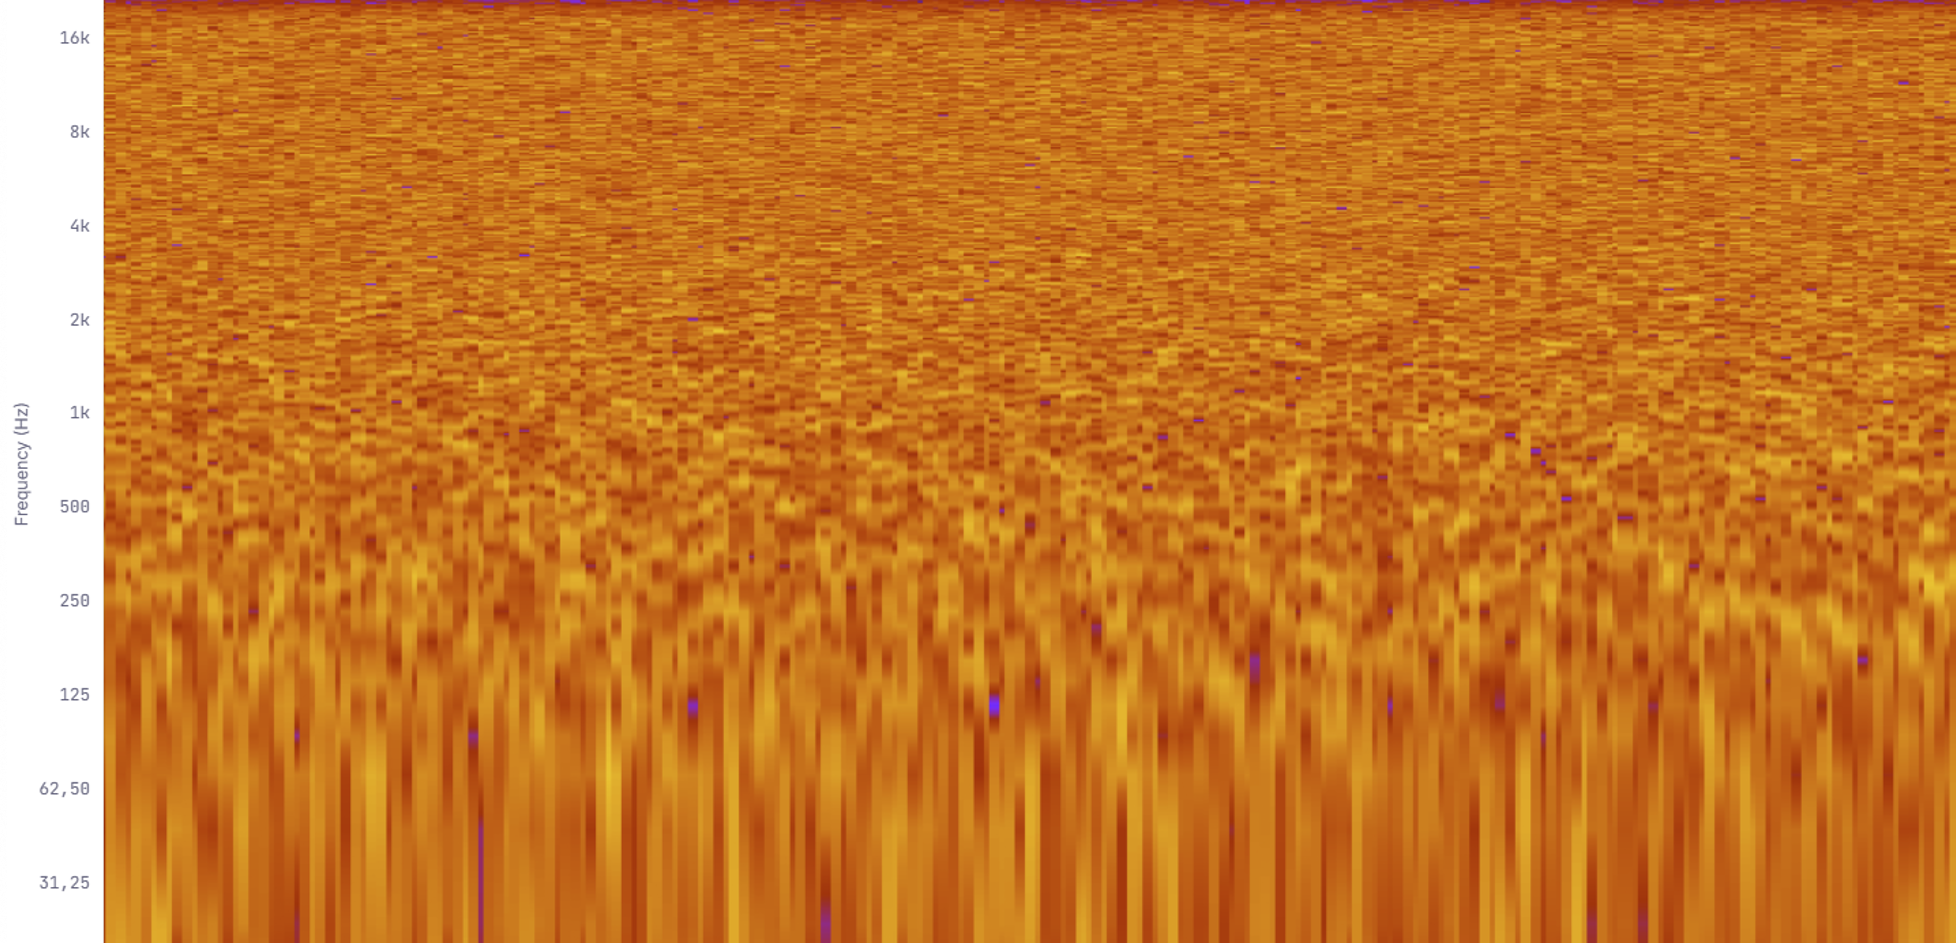
Ce qui a été démontré par la transformation de Fourier plus haut est maintenant encore plus visuel : avec notre son généré à base d’amplitudes aléatoires pour chaque échantillon (sample), nous voyons bien ici que, statistiquement, toutes les fréquences sont représentées à parts à peu près égales sur le spectre.
Grâce à cette échelle, on peut facilement voir les octaves. Si on trace des lignes, on retrouve alors visuellement notre problème :
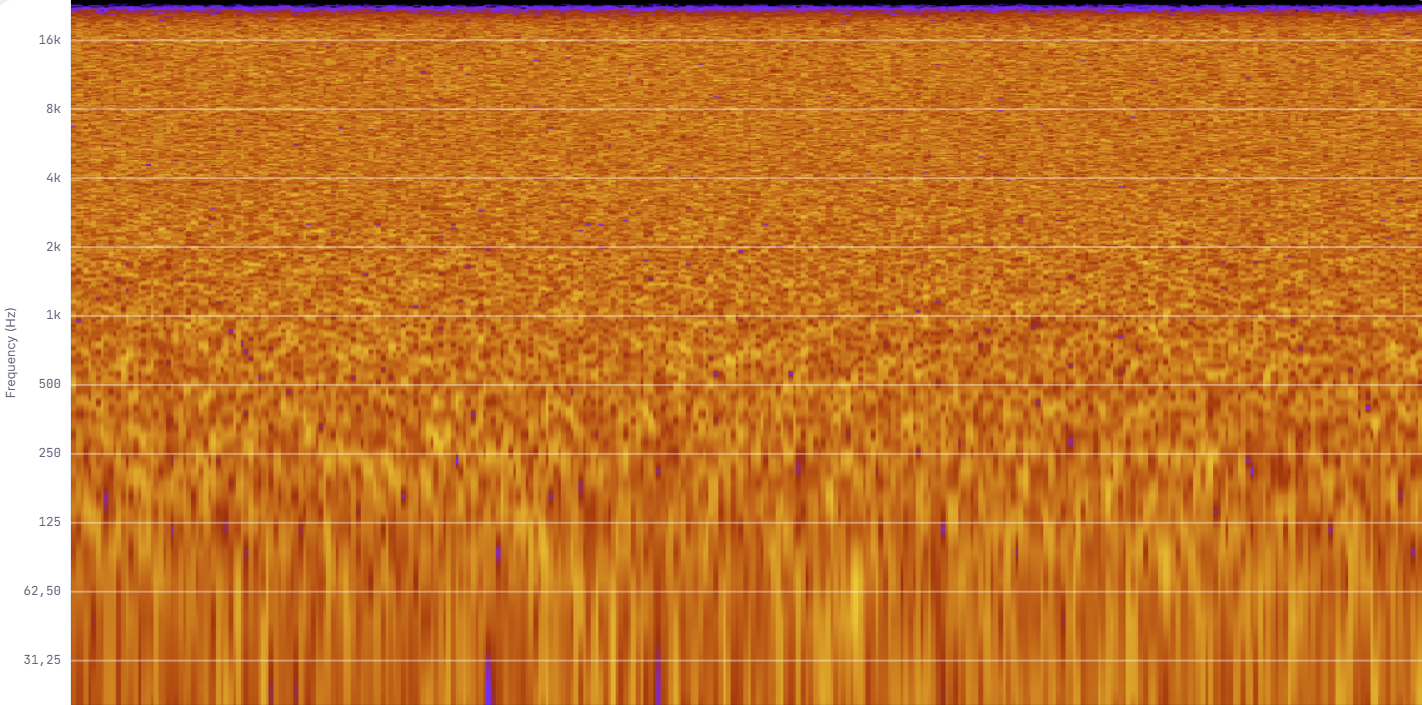
On voit bien que pour chaque bande d’octave, on a une densité doublée de fréquences par rapport à la précédente.
Nous pouvons alors percevoir la solution : une variante de bruit blanc, pour laquelle la densité spectrale de puissance reste constante par bande d’octave.
Ce bruit serait alors comme un bruit blanc, mais adapté à notre perception acoustique, puisque nous percevrions réellement autant de fréquences hautes que basses, et nous pourrions avoir ce bruit neutre recherché.
Ce bruit porte un nom : le bruit rose.
Le bruit rose
Principe du bruit rose
Définition Wikipédia : Le bruit rose est un signal aléatoire dont la densité spectrale est constante par bande d’octave. Sa densité spectrale de puissance est inversement proportionnelle à la fréquence du signal.
Dit plus simplement : à chaque fois que la fréquence double, la puissance par hertz est divisée par deux. C’est ce qu’on note 1/f : la puissance décroît comme l’inverse de la fréquence. Et comme on l’a vu plus haut, une octave contient deux fois plus de hertz que la précédente. Deux fois plus de fréquences, chacune deux fois moins puissante : ça fait la même énergie par octave. Les deux phrases de la définition disent donc la même chose.
Il existe un algorithme justement conçu pour générer des bruits roses : l’algorithme de Voss-McCartney.
Algorithme de Voss-McCartney
L’algorithme de Voss-McCartney est une méthode très efficace pour fabriquer du bruit rose (plus exactement une très bonne approximation de cette décroissance en 1/f). Le principe est de mélanger plusieurs sources de bruit blanc indépendantes, mais avec une astuce : elles ne “bougent” pas toutes à la même vitesse.
- Les sources qui créent les sons aigus changent de valeur tout le temps (très vite).
- Les sources qui créent les sons graves changent de valeur beaucoup moins souvent. En additionnant tout ça, on obtient un équilibre quasi parfait qui imite notre perception : chaque octave reçoit la même dose d’énergie.
Voici le pseudo-code théorique de cet algorithme :
|
|
Prenons 16 sources, ce qui est un bon compromis.
On couvre alors 16 octaves bien qu’il n’y en ait que 10 dans le spectre audible humain, afin que la décroissance en 1/f tienne jusqu’en bas du spectre audible. En dessous de la fréquence à laquelle la source la plus lente change de valeur, plus aucune source ne vient renforcer les graves : le spectre redevient plat, comme celui d’un bruit blanc.
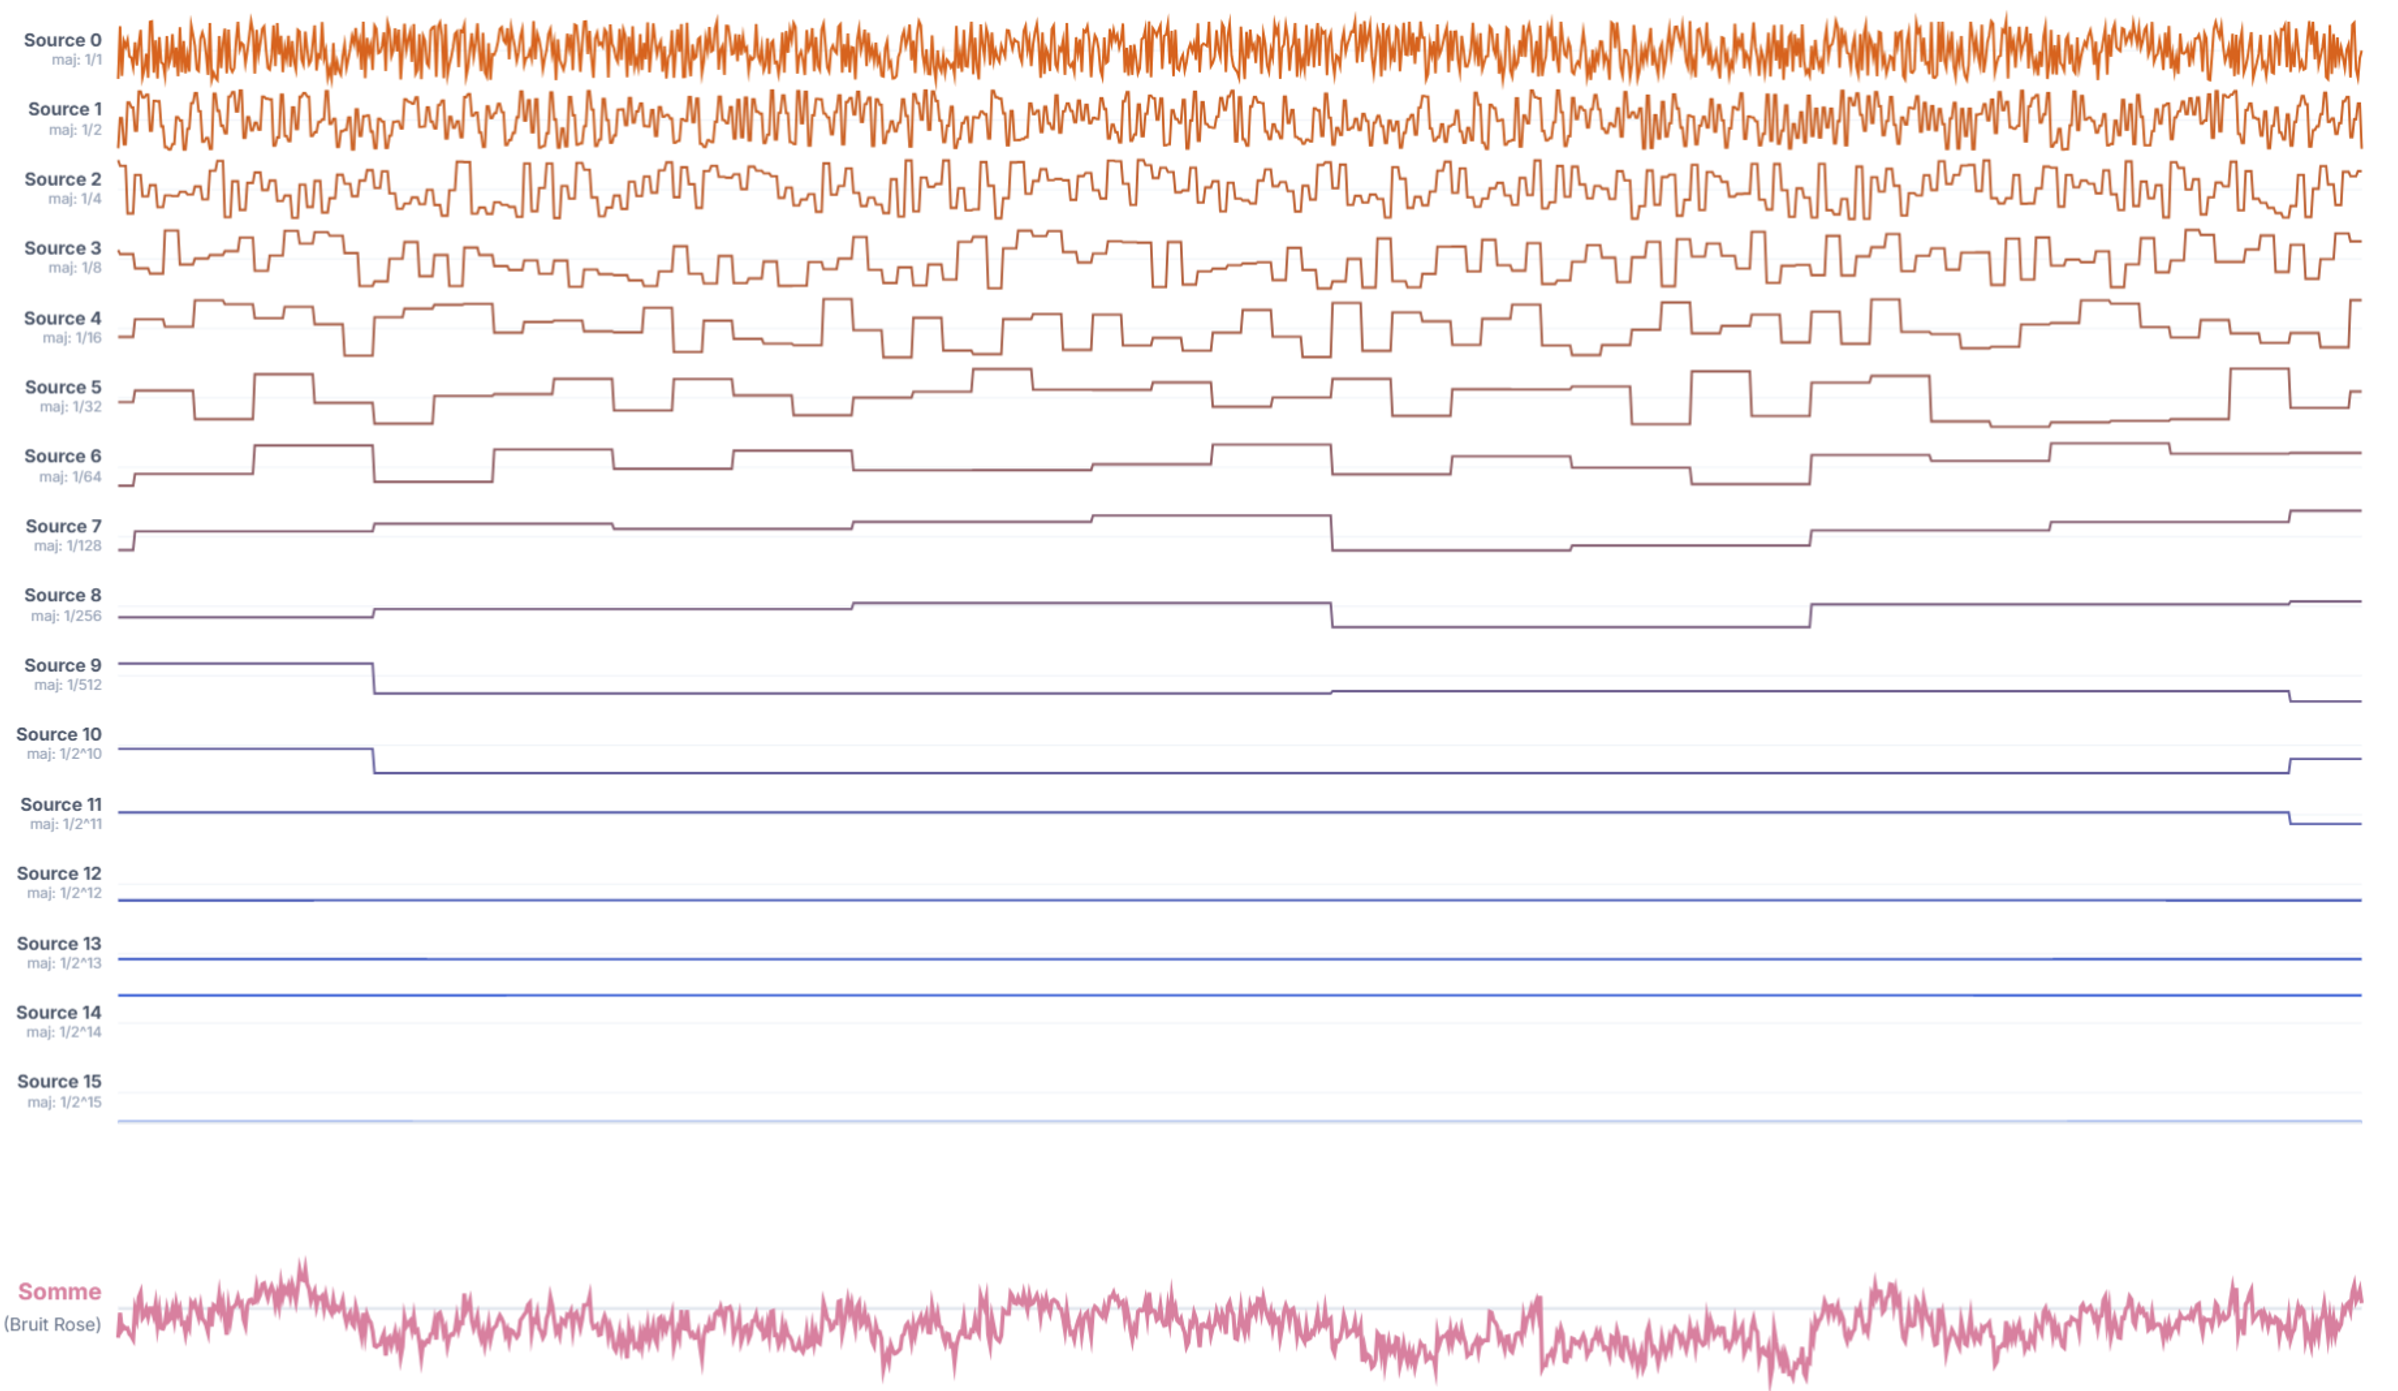
On se retrouve alors avec 16 bruits blancs, mais chaque bruit blanc reste “immobile” deux fois plus longtemps que le précédent.
Si le bruit blanc classique contient toutes les fréquences comme nous l’avons vu précédemment, des infra-basses à 22 kHz, le bruit blanc suivant, qui sur l’échantillonnage change de valeur deux fois moins souvent, ne contiendra, pour l’essentiel, que les fréquences jusqu’à 11 kHz, et ainsi de suite.
Chaque source de bruit blanc contient donc deux fois plus de puissance dans les graves que la précédente.
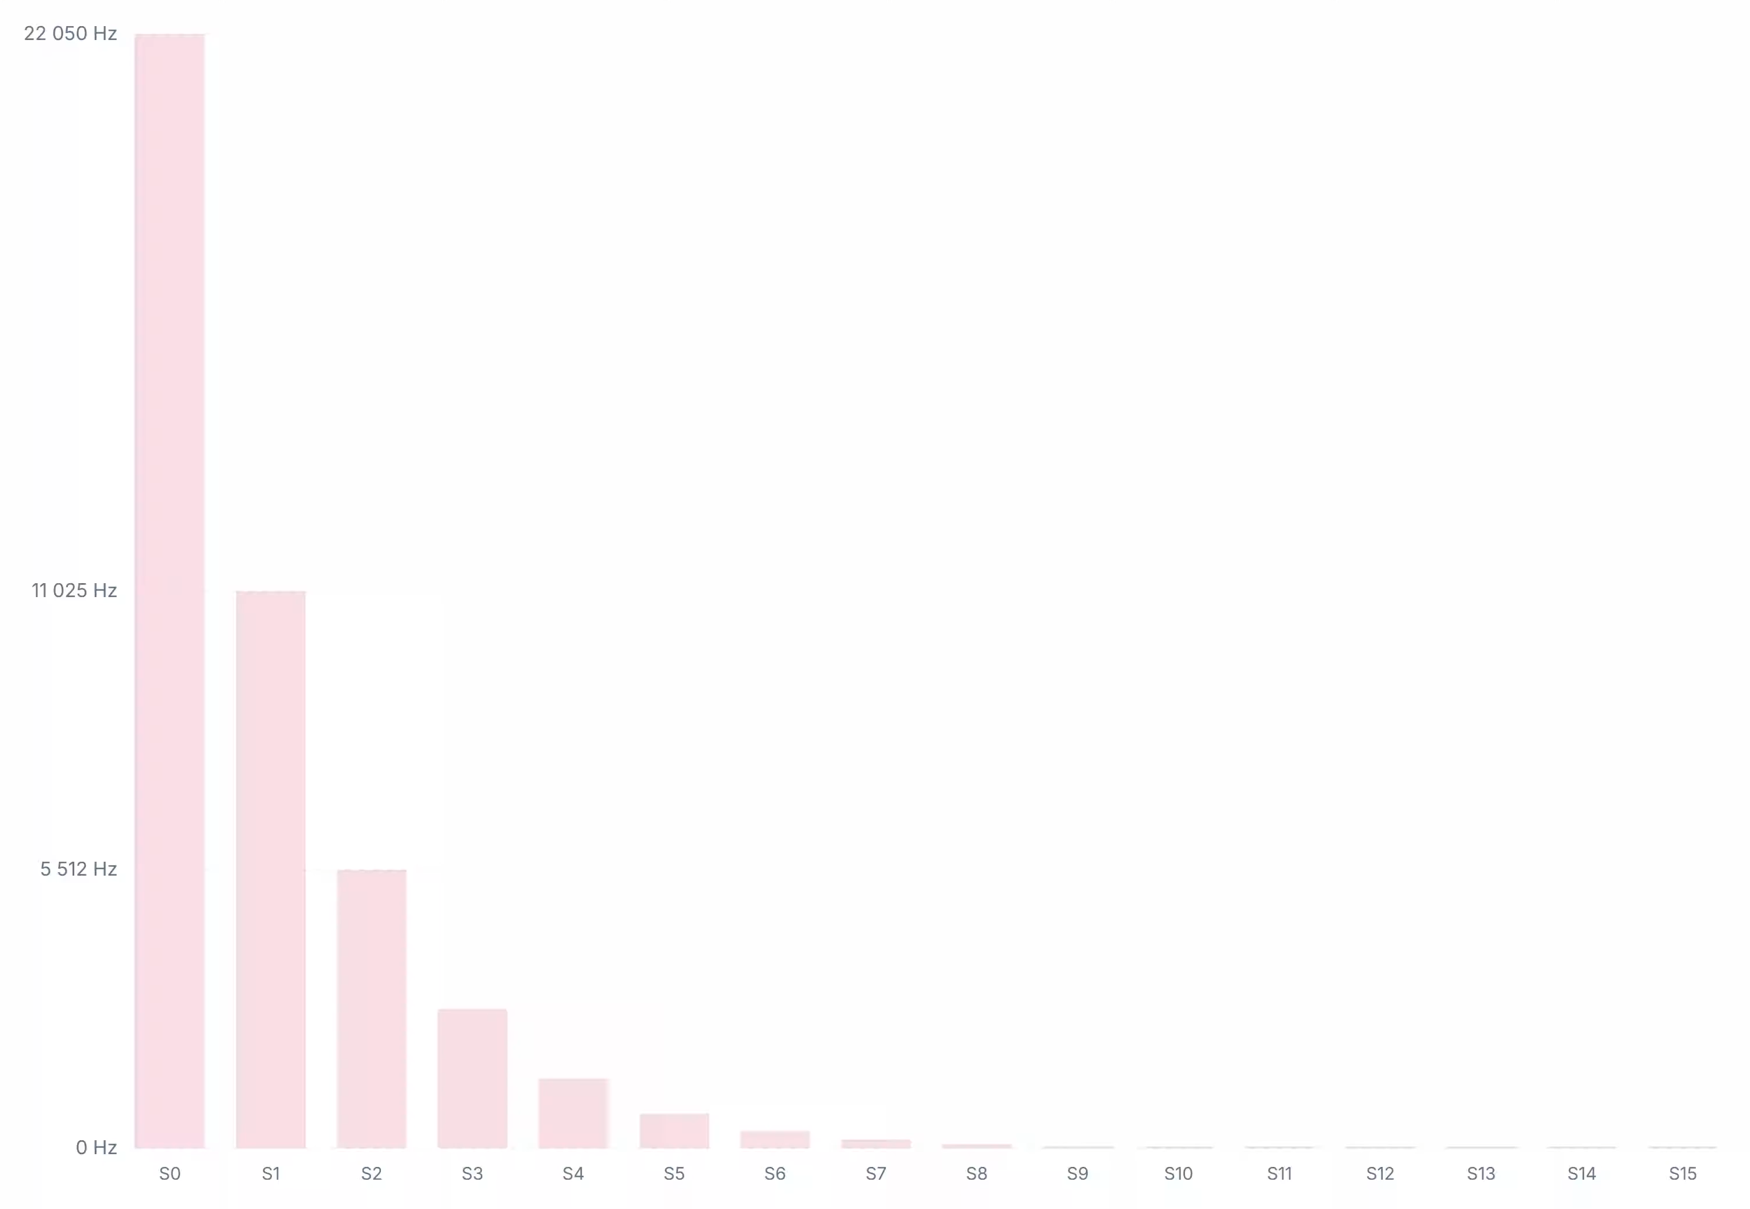
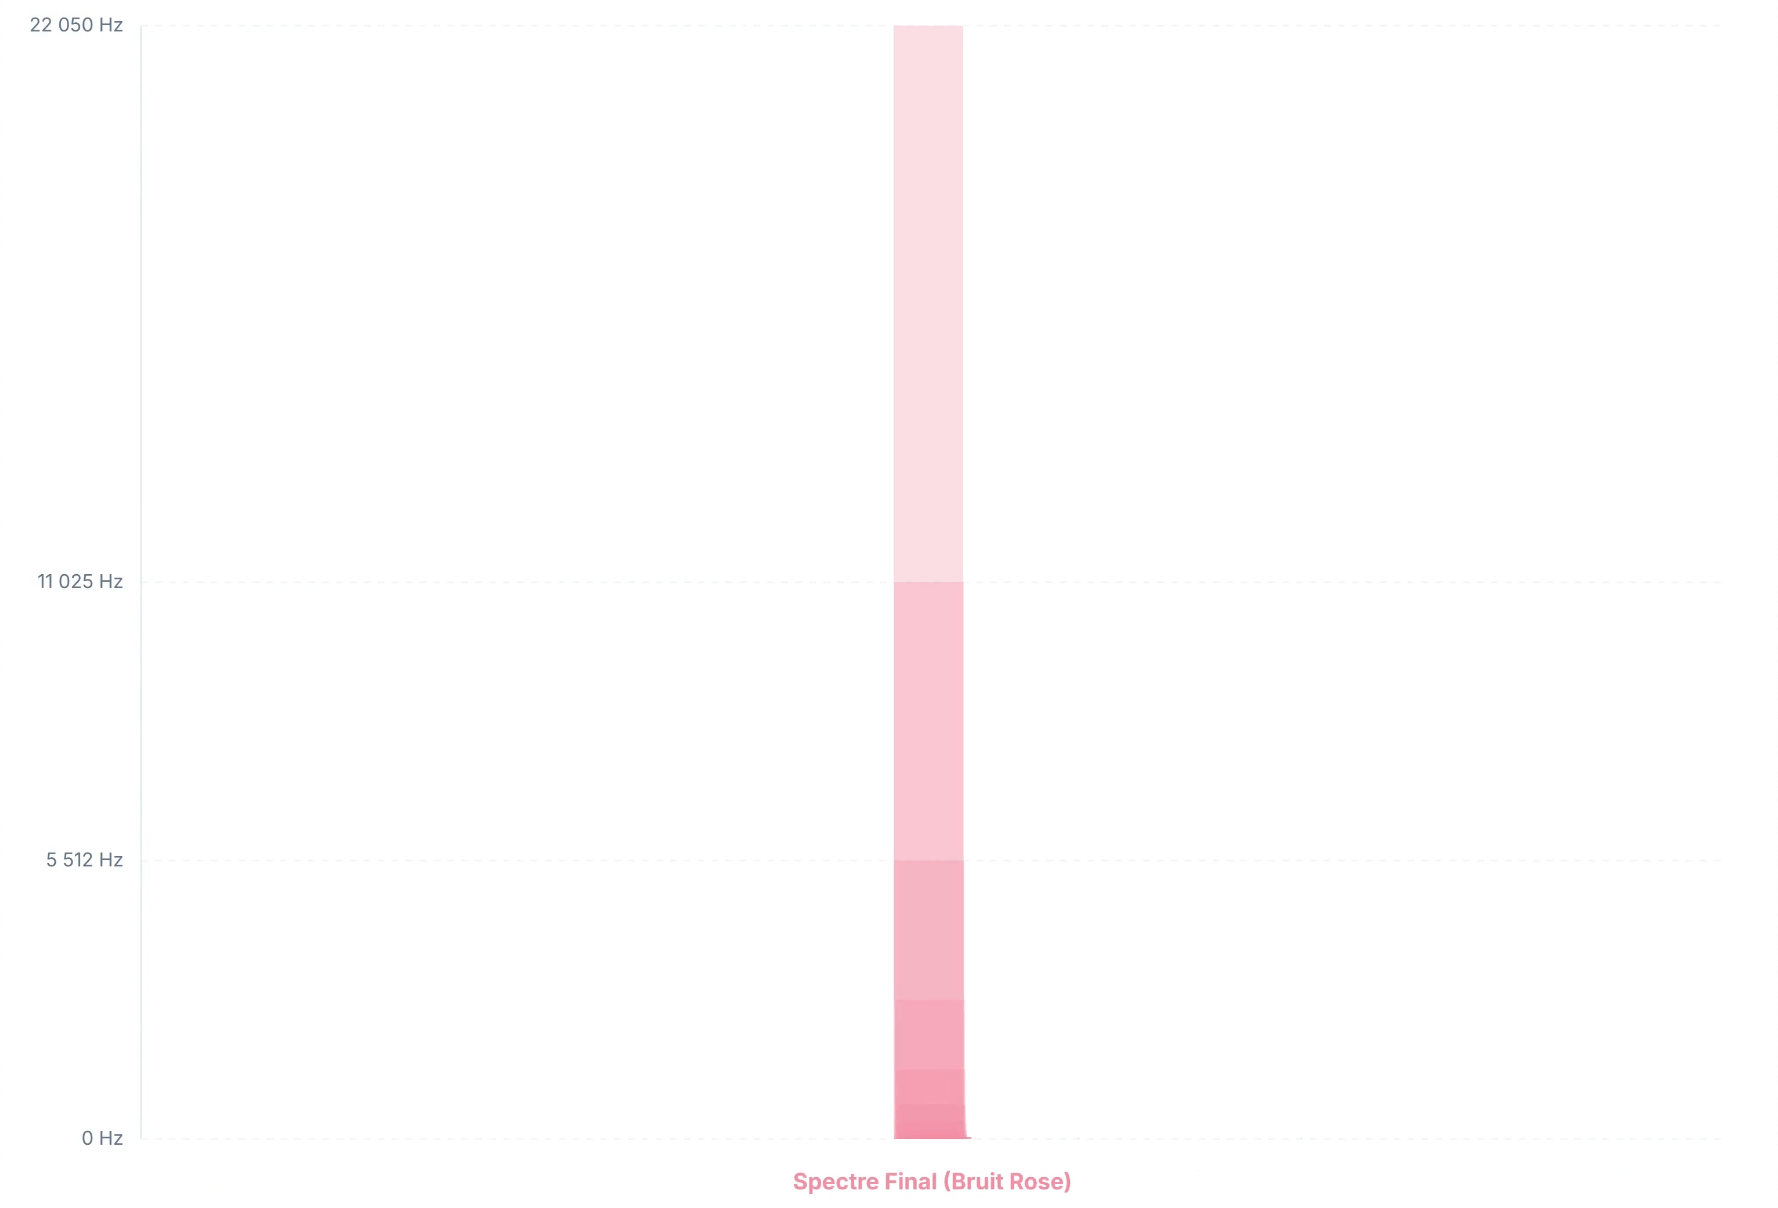
En additionnant toutes ces sources, on se retrouve alors avec une composition de bruits blancs qui contient plus de fréquences basses que de fréquences hautes, et ce à une échelle logarithmique.
Un bruit rose, donc.
Voici mon implémentation en C++ :
|
|
Et voilà, nous avons notre bruit rose !
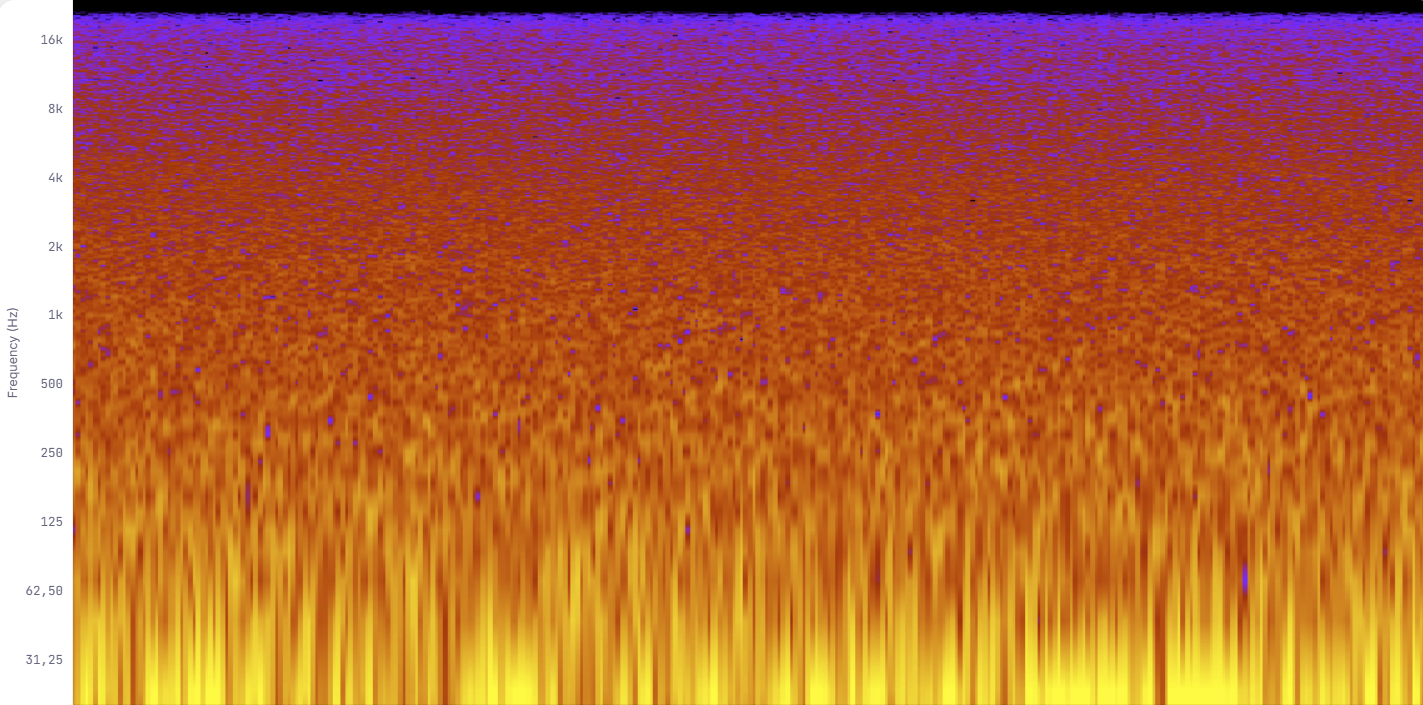
Écoutons-le pour voir :
Description du son : on retrouve la sonorité du bruit blanc, mais en beaucoup plus doux. Le bruit rappelle un peu celui d’une mer peu agitée.
C’est bien mieux, le son n’est plus agressif, mais il est encore un peu trop granuleux pour qu’on puisse le considérer comme un bruit relaxant.
La raison à cela est d’abord qu’un bruit rose, même parfait, garde beaucoup d’énergie dans les aigus, là où notre oreille est justement la plus sensible (entre 2 et 5 kHz environ). À cela s’ajoute le fait que l’algorithme de Voss-McCartney travaille les valeurs de l’échantillonnage par octaves, avec des sources en escalier, comme nous venons de le voir.
La conséquence à ça est qu’on se retrouve avec des sauts abrupts à chaque fois qu’une source change de valeur. Et rappelez-vous : des sauts importants d’amplitude signifient qu’on génère des hautes fréquences lors de ces transitions.
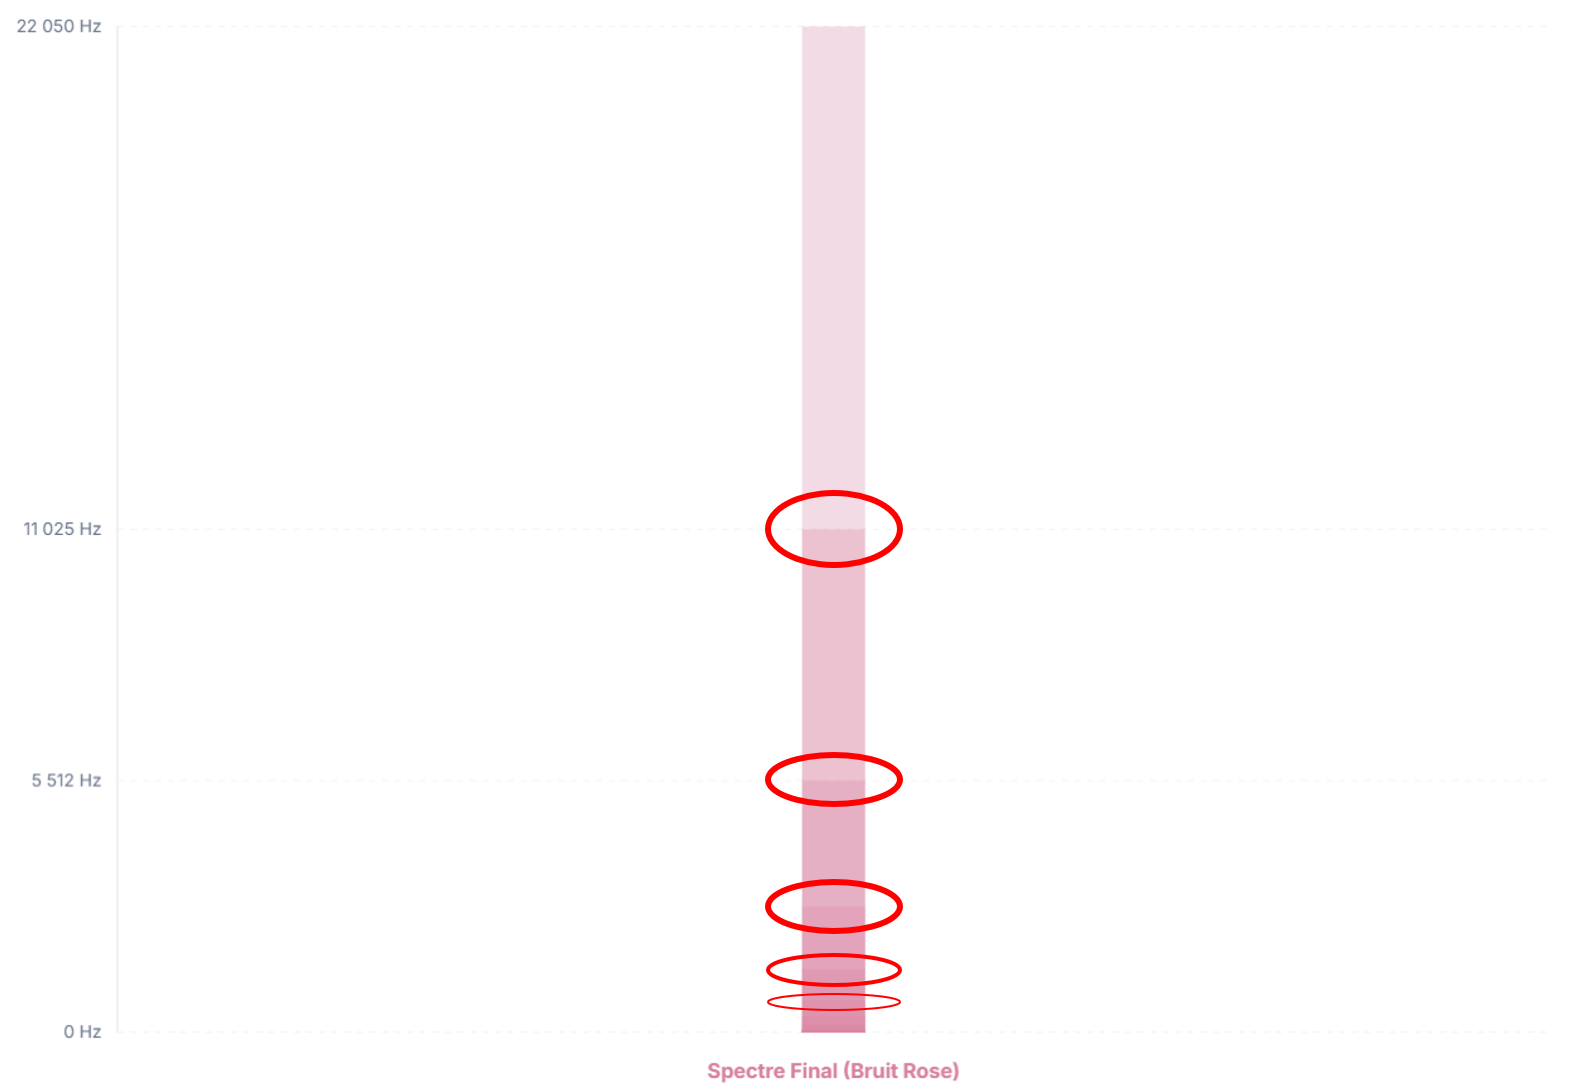
Cet algorithme nous offre alors presque la bonne solution, mais il faut y ajouter un correctif, quelque chose qui va nous permettre de lisser ces hautes fréquences parasites.
En physique, il existe un outil justement conçu pour lisser, voire éliminer, certaines fréquences : les filtres.
FFT-based filtering
Pour parler des filtres, rien de mieux que de présenter l’un des plus fascinants : le filtre basé sur la transformation de Fourier rapide (FFT-based filtering).
Le fonctionnement de ce filtre est plutôt simple. On commence par décomposer un signal acoustique selon les différentes fréquences qui le composent. Une fois que c’est fait, nous pouvons sélectionner les fréquences que nous souhaitons éliminer, avant d’effectuer une transformation de Fourier inverse afin de reconstituer le signal.
Nous obtenons donc un signal similaire à celui d’origine, mais en ayant éliminé les fréquences dont nous ne voulions pas.
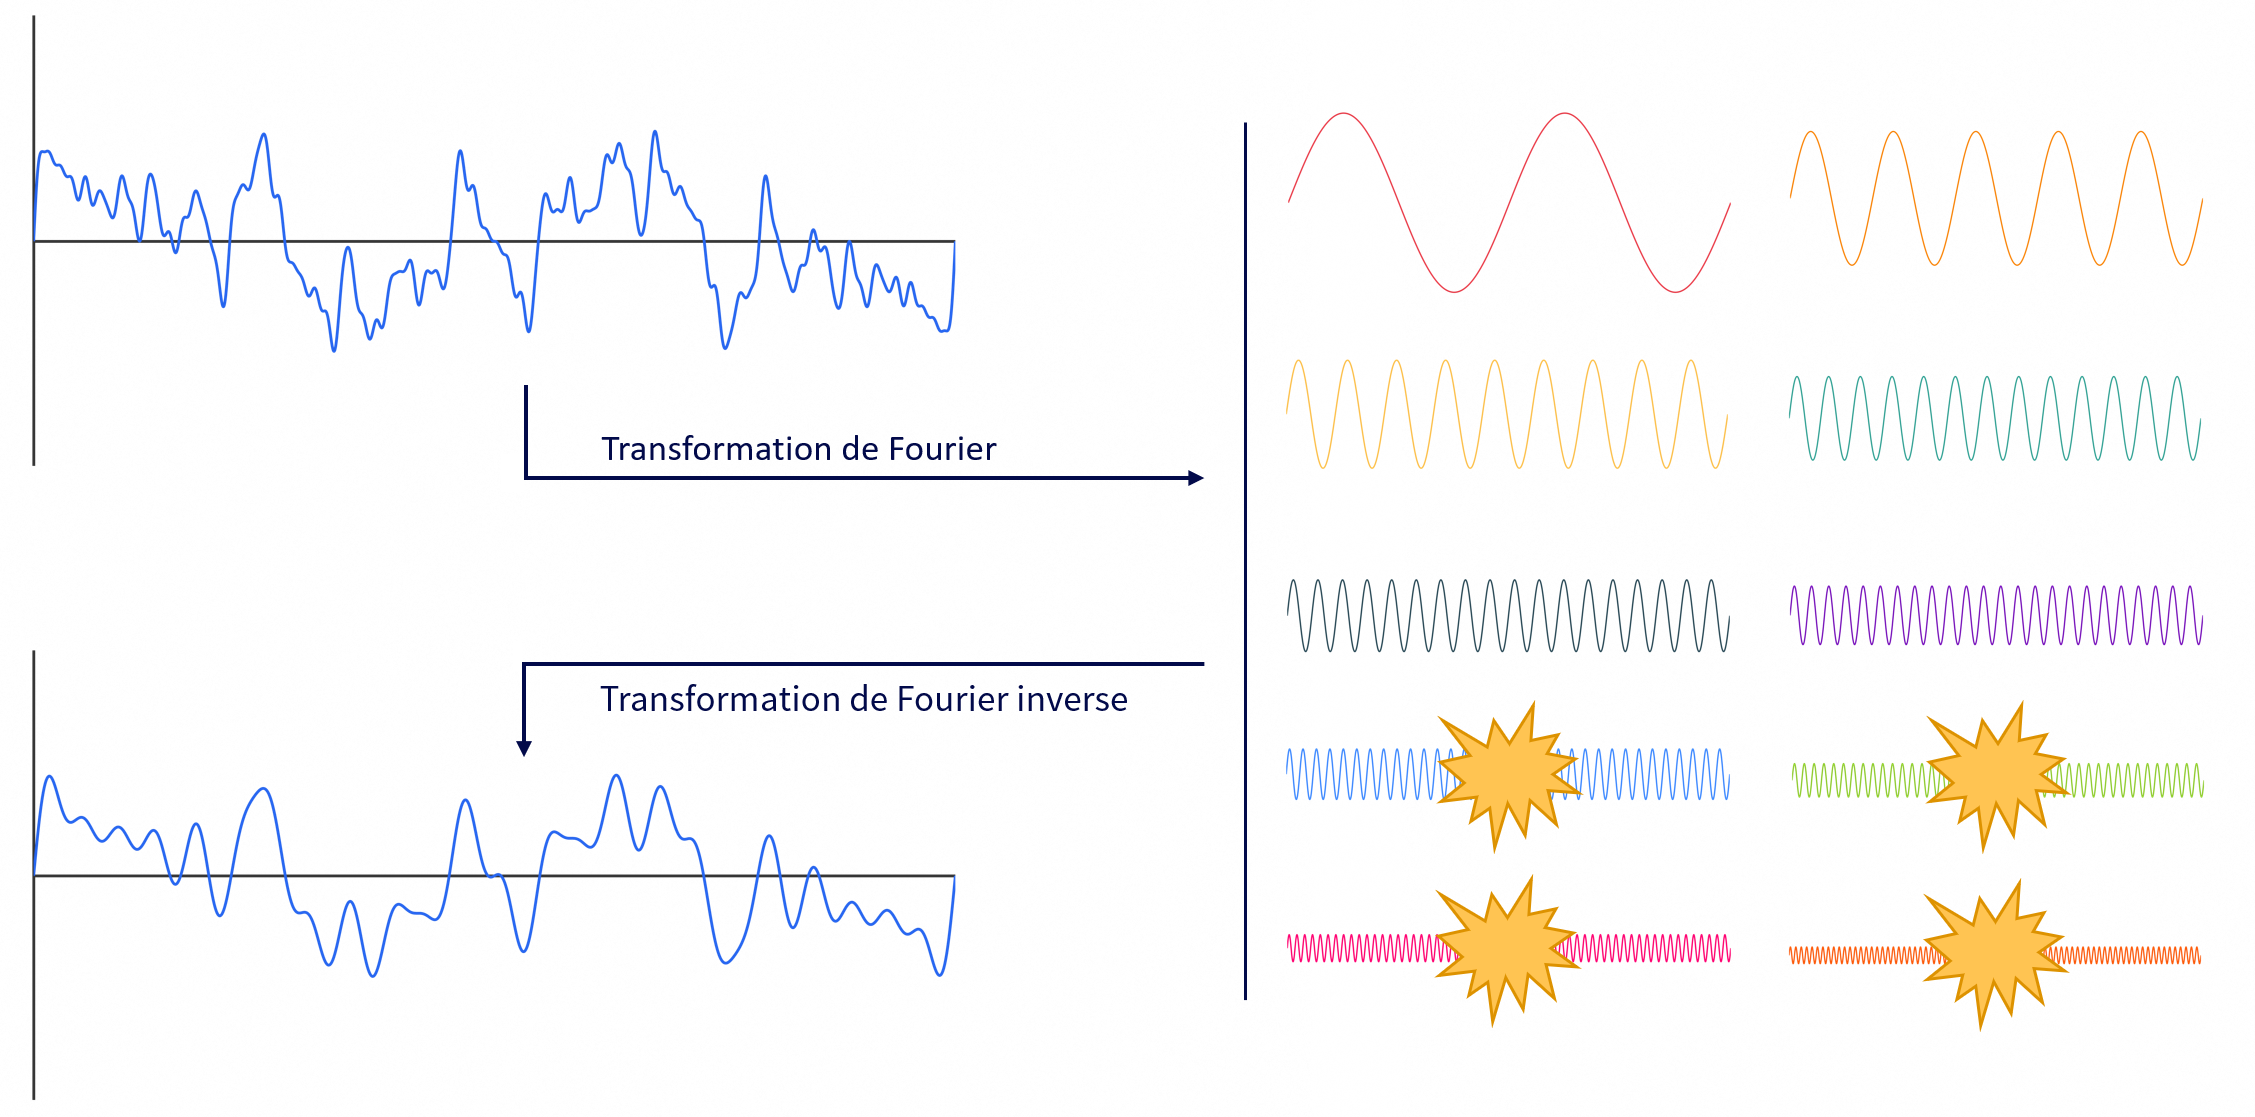
Nous pouvons voir sur cet exemple comment lisser un signal en éliminant les hautes fréquences.
C’est d’ailleurs une partie du fonctionnement des appareils auditifs qui permettent d’amplifier seulement certaines plages de fréquences que le patient aurait des difficultés à entendre de manière naturelle. Les appareils auditifs ne peuvent malheureusement pas s’appuyer uniquement là-dessus à cause du retard induit par le temps de calcul, mais ça donne une idée de ce que ce genre de filtre peut faire : débruitage audio et restauration sonore, traitement et compression d’images, télécommunications, radar, sonar, géophysique…
Lorsque l’on conçoit un filtre qui ne laisse passer que les basses fréquences, on appelle ça un filtre passe-bas. Pour notre cas, il nous faut un filtre passe-bas à atténuation très progressive au-delà de la fréquence de coupure. La fréquence de coupure, c’est la limite à partir de laquelle un filtre commence à agir : en dessous, le son passe tel quel, au-dessus, il est de plus en plus atténué (par convention, c’est le point où le signal a perdu 3 dB, soit environ 30 % de son amplitude). Il existe un filtre tout indiqué pour cela : le filtre passe-bas à un pôle (One Pole).
Filtre passe-bas One Pole
Un filtre passe-bas, dans sa forme la plus simple, peut s’écrire comme ça :
|
|
C’est tout. Une ligne. Et pourtant, c’est un filtre à part entière.
On l’appelle un filtre One Pole (ou filtre IIR du premier ordre), et c’est probablement le filtre numérique le plus utilisé au monde.
Décomposons-le :
filterState: la valeur de sortie actuelle du filtre, c’est-à-dire le son filtré de l’échantillon précédent. C’est la mémoire du filtre.input: la valeur brute de l’échantillon actuel.smoothing: un coefficient compris entre 0.0 et 1.0 qui contrôle à quel point le filtre est “lent” à réagir.
L’idée est simple : au lieu d’utiliser directement la valeur brute de l’échantillon courant, on calcule une moyenne pondérée entre la sortie précédente et l’entrée courante.
Si smoothing est proche de 1, le filtre “résiste” beaucoup aux changements rapides : la sortie évolue lentement, le son devient très doux et les aigus disparaissent.
Si smoothing est proche de 0, le filtre laisse presque tout passer : la sortie suit de très près l’entrée, et l’effet est quasi nul.
Cela signifie que chaque échantillon devient dépendant de l’histoire du signal. La valeur de l’entrée n’est plus une destination immédiate, mais plutôt une direction vers laquelle on pousse l’amplitude actuelle. En limitant ainsi la vitesse de variation entre deux échantillons, on empêche les changements brusques : le signal est “freiné”, ce qui entraîne une atténuation naturelle des hautes fréquences.
Ce filtre est dit récursif : sa sortie dépend de sa propre sortie précédente. C’est précisément cette boucle de rétroaction qui lui donne son effet de lissage. À chaque échantillon, il “se souvient” un peu de ce qu’il vient de produire, et il en tient compte pour calculer sa prochaine valeur.
La fréquence de coupure du filtre (c’est-à-dire la fréquence à partir de laquelle il commence à atténuer le signal) dépend directement de smoothing et de la fréquence d’échantillonnage. Plus smoothing est élevé, plus cette fréquence de coupure est basse, et plus le son est amorti.
Dans mon cas, avec smoothing = 0.8f (ce qui donne, à 44 100 Hz, une fréquence de coupure d’environ 1 600 Hz : en dessous, le bruit passe presque intact, au-dessus, il s’adoucit de plus en plus), le filtre coupe suffisamment les transitoires les plus aigus du bruit rose sans trop dénaturer la richesse du signal. Le résultat est un son nettement plus rond.
La formule est d’ailleurs plus lisible avec une valeur de smoothing définie, comme 0.8 :
|
|
On pourrait la traduire par “chaque nouvel échantillon de sortie conserve 80 % de la sortie précédente et n’intègre que 20 % de la nouvelle entrée”.
Voici à quoi ressemblera donc un signal auquel nous appliquons ce filtre, avec un smoothing de plus en plus élevé jusqu’à atteindre 0.8 :
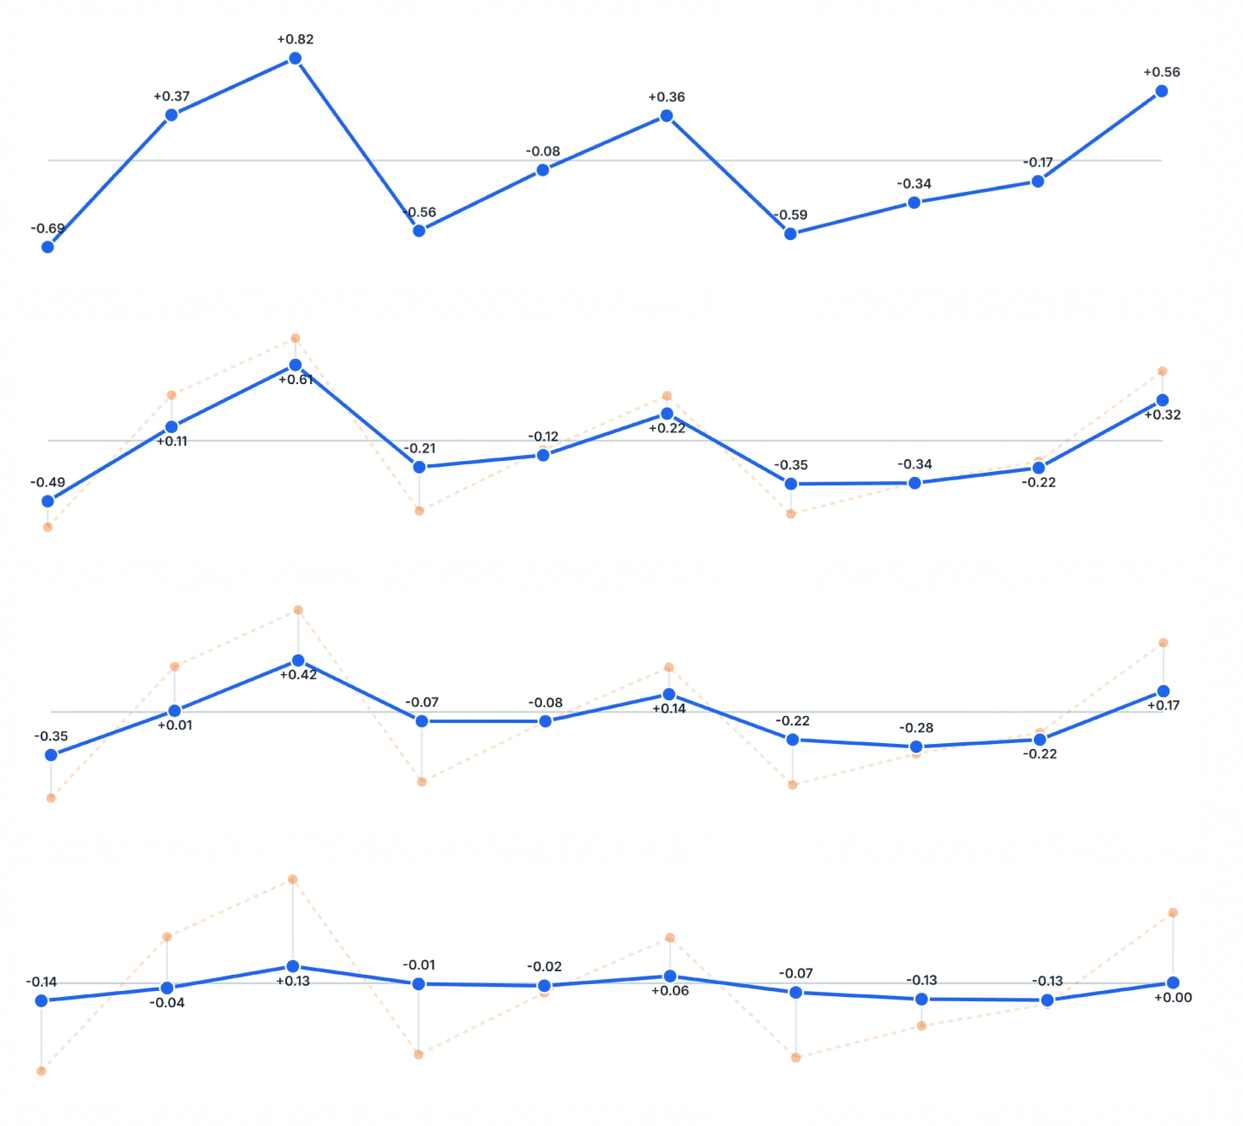
Il ne nous reste plus qu’à appliquer ce filtre sur notre bruit rose.
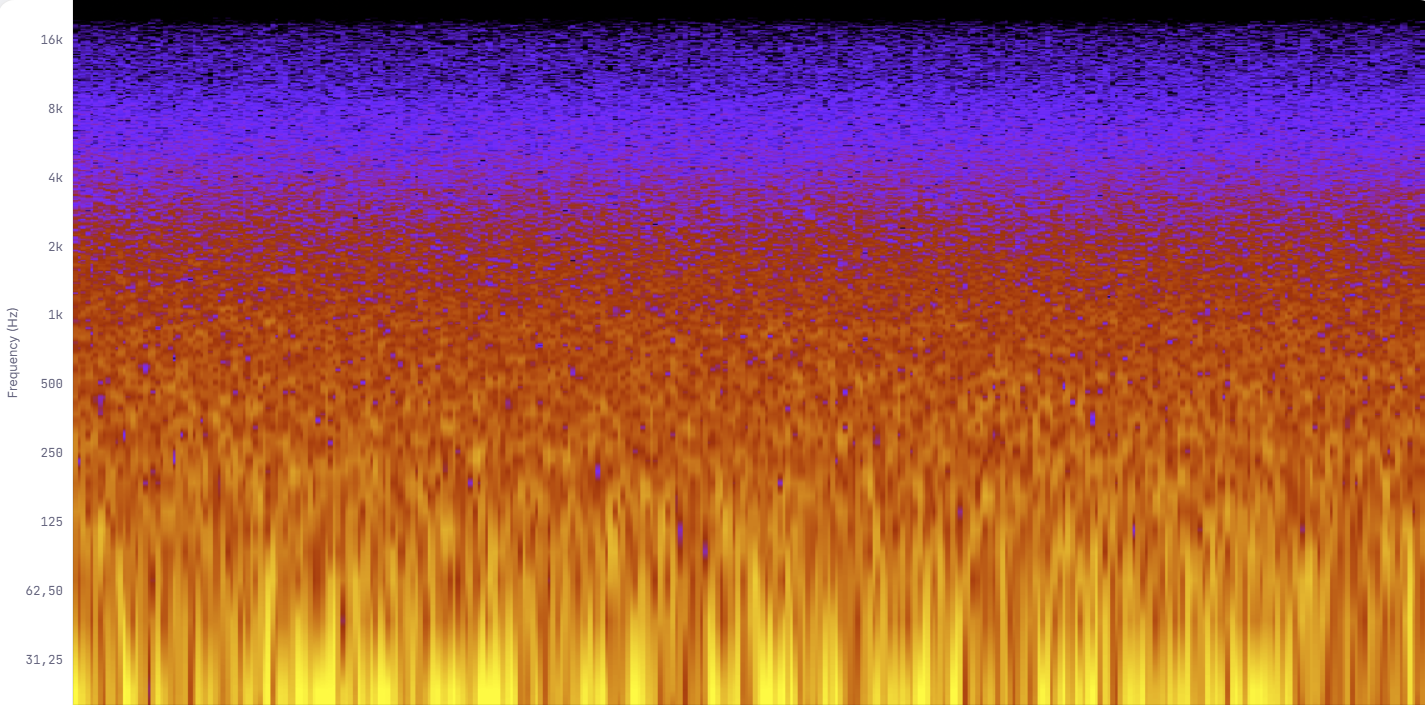
Bruit rose + filtre passe-bas
Voilà à quoi ressemble notre bruit rose auquel nous avons ajouté un filtre passe-bas :
Passons à l’écoute :
Description du son : un bruit similaire à une légère brise ou au léger bruit d’une mer calme.
Nous avons enfin réussi ! En produisant notre premier bruit blanc, en comprenant comment il fonctionne, puis en façonnant ainsi un bruit rose atténué par un filtre passe-bas, nous avons accompli notre objectif : un son parfaitement fonctionnel pour soulager un acouphène ou encore aider quelqu’un à se concentrer.
C’est une belle victoire. Il y a encore tant de choses à dire dans ce domaine, mais je vais me contenter de vous présenter deux derniers bruits.
Autres bruits colorés
Tout d’abord, il est intéressant de savoir qu’il existe l’opposé du bruit rose (qu’on obtient par exemple en dérivant un bruit rose) : un bruit dont la densité spectrale de puissance est proportionnelle à la fréquence du signal (et non inversement proportionnelle). Ça produit l’exact opposé de ce qu’on veut : un bruit strident et très désagréable à l’oreille.
Ce son, c’est le bruit bleu.
Mais aussi, bien que le bruit rose soit l’un des plus utilisés par certaines personnes pour ce besoin, il existe un autre bruit très connu et préféré par d’autres : le bruit rouge.
Bruit rouge
Si le bruit blanc est le chaos absolu et le bruit rose son équilibre logarithmique, le bruit rouge est quelque chose de plus profond, plus grave.
Définition Wikipédia : Le bruit rouge (ou bruit brownien) est un signal dont la densité spectrale de puissance décroît en 1/f², soit une atténuation de 6 dB par octave. Il s’agit du bruit associé au mouvement brownien.
Le mouvement brownien, c’est le mouvement aléatoire d’une particule soumise à des chocs perpétuels avec les molécules d’un fluide. Un grain de pollen dans de l’eau, par exemple.
Mais ce qui nous intéresse ici, c’est son équivalent audio : à chaque instant, le signal ne part pas dans n’importe quelle direction. Il se déplace à partir de là où il était.
C’est exactement la logique de mon implémentation :
|
|
Là où le bruit blanc assignait une valeur indépendante à chaque échantillon, ici on accumule : chaque nouvelle valeur est la précédente, plus un tout petit pas aléatoire (white * 0.02f). Le signal ne saute pas, il dérive.
Le jlimit est simplement là pour éviter que la dérive ne s’emballe et ne sorte des bornes.
On décrit la forme de ce signal comme une “marche aléatoire”.
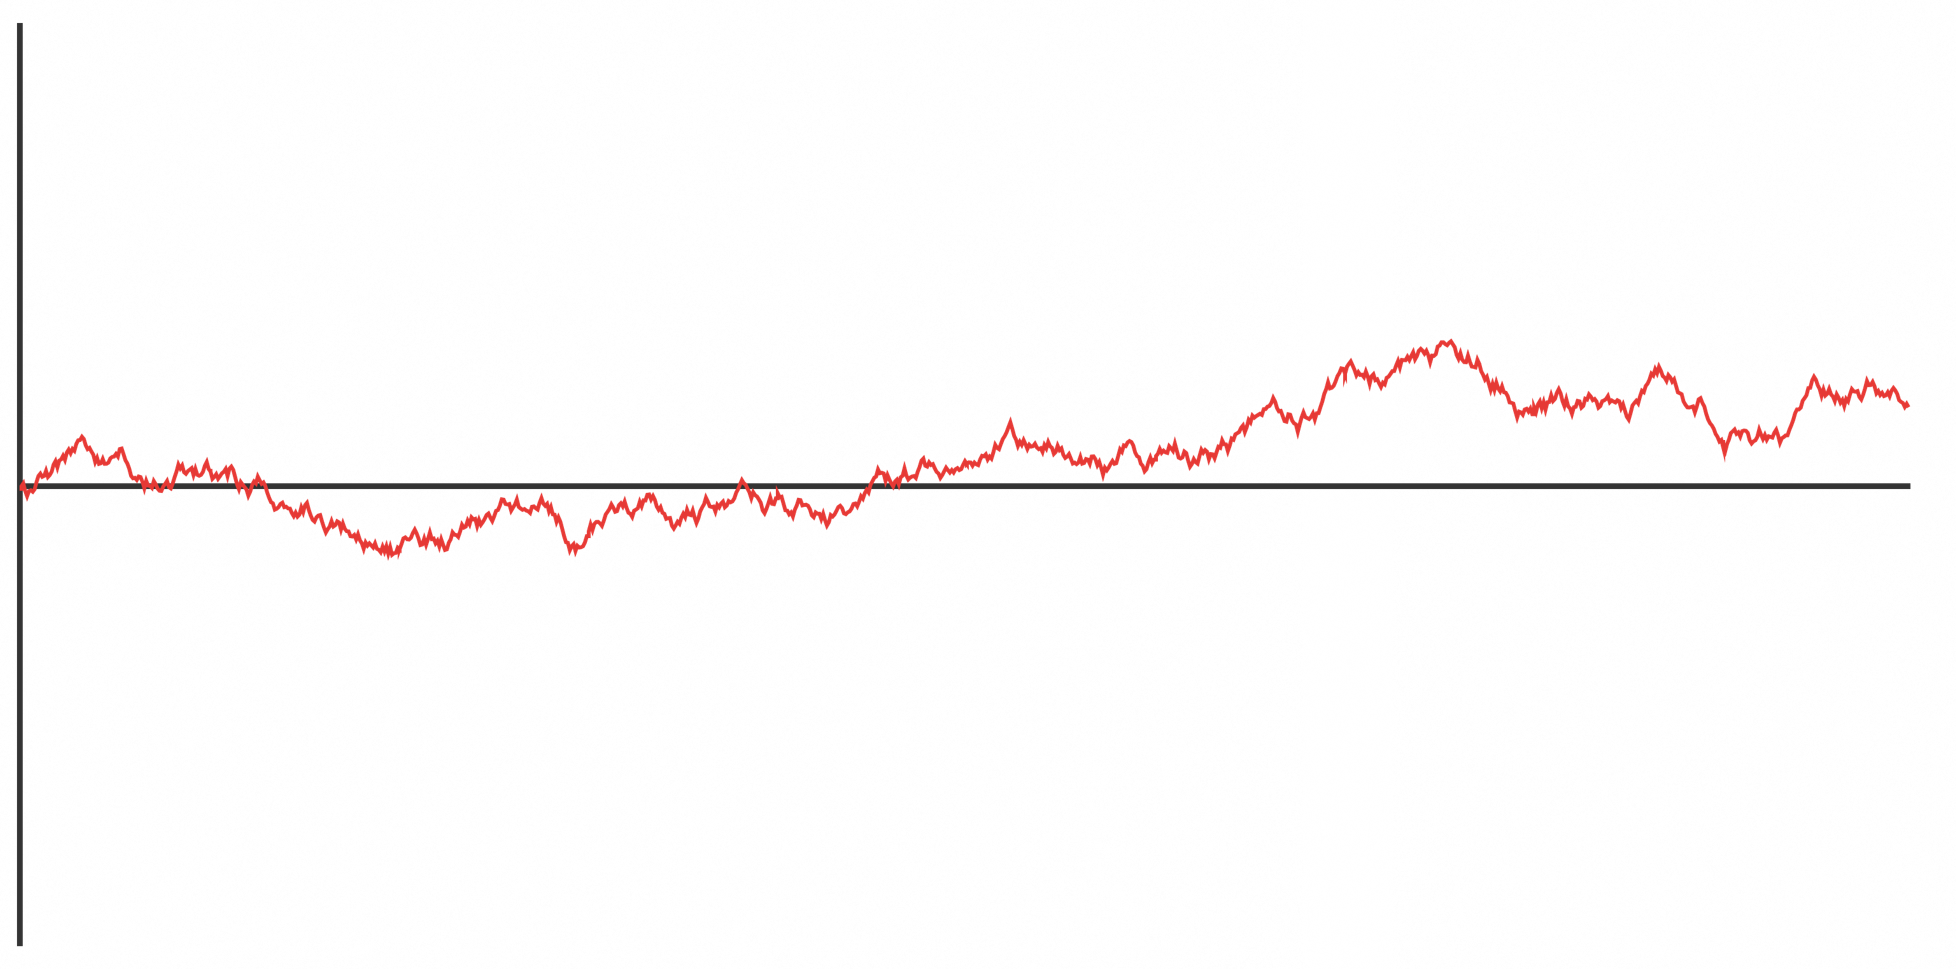
Le résultat sonore est quelque chose de beaucoup plus grave et roulant, qui ressemble à un tonnerre lointain, à des vagues, à une rivière souterraine. Moins agressif que le bruit blanc, plus mat que le bruit rose.
Visuellement, sur le spectrogramme, la différence est immédiate : là où le bruit blanc tapissait tout le spectre de manière homogène, le bruit brun s’écrase vers les basses. L’énergie est très fortement concentrée dans les fréquences graves, et chute régulièrement vers les aigus, à 6 dB par octave.
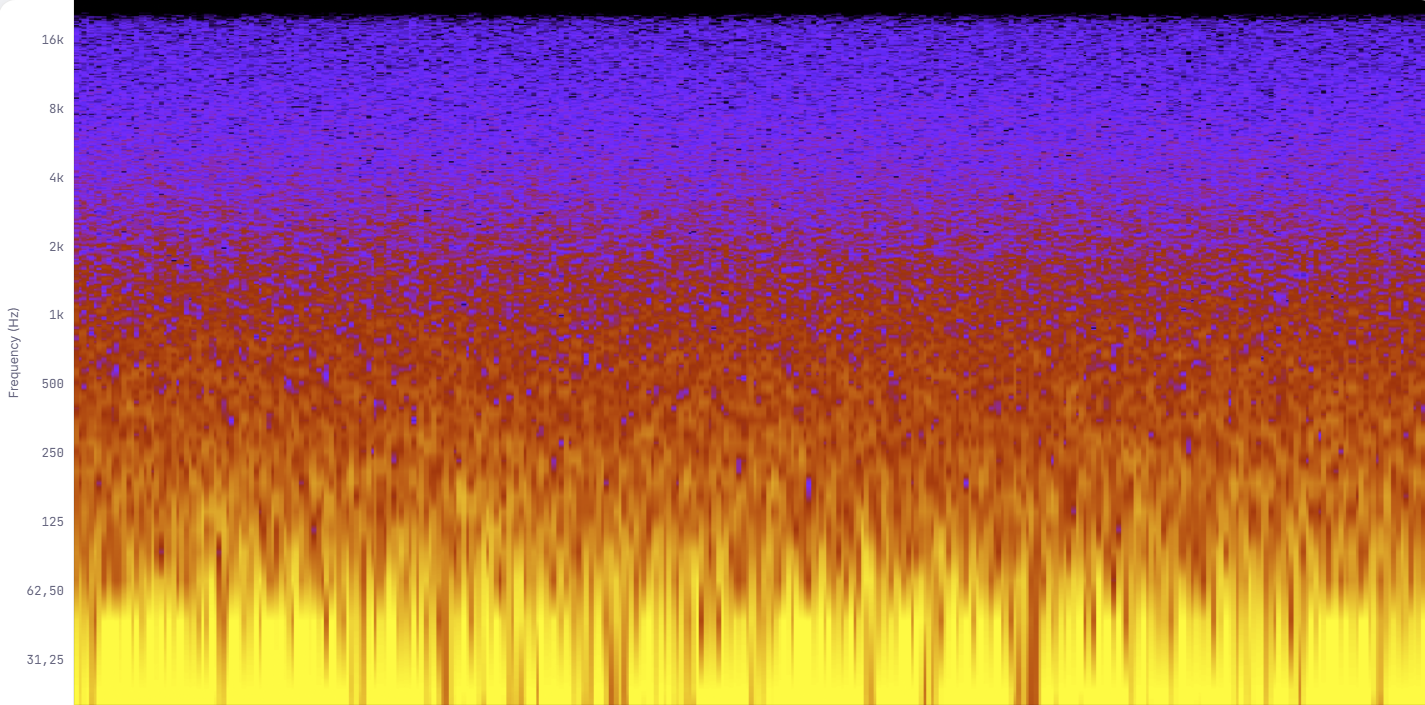
Passons à l’écoute :
Description du son : un bruit similaire à une légère brise ou au léger bruit d’une mer calme, mais avec un léger fond orageux.
Il existe encore d’autres bruits colorés, tels que le violet, le gris ou le velvet. Une page Wikipédia y est dédiée, n’hésitez pas si vous voulez en découvrir plus : https://en.wikipedia.org/wiki/Colors_of_noise
Nous arrivons à la fin de ce que je voulais vous raconter sur les bruits colorés !
Avant de nous quitter, je voulais finir sur une note amusante. Quand vous avez réalisé que l’on pouvait visualiser les fréquences d’un son, ne vous êtes-vous pas dit que l’on pouvait s’en servir pour cacher des messages sur un spectrogramme ? Moi, oui !
Ce procédé appartient à un principe que l’on appelle la stéganographie.
Bonus : stéganographie
La stéganographie, c’est l’art de dissimuler un message dans un support anodin, de telle sorte que sa seule présence reste imperceptible. Pas de clé, pas de chiffrement visible. Le secret, c’est que le message est là mais que personne ne le voit (ou ne l’entend).
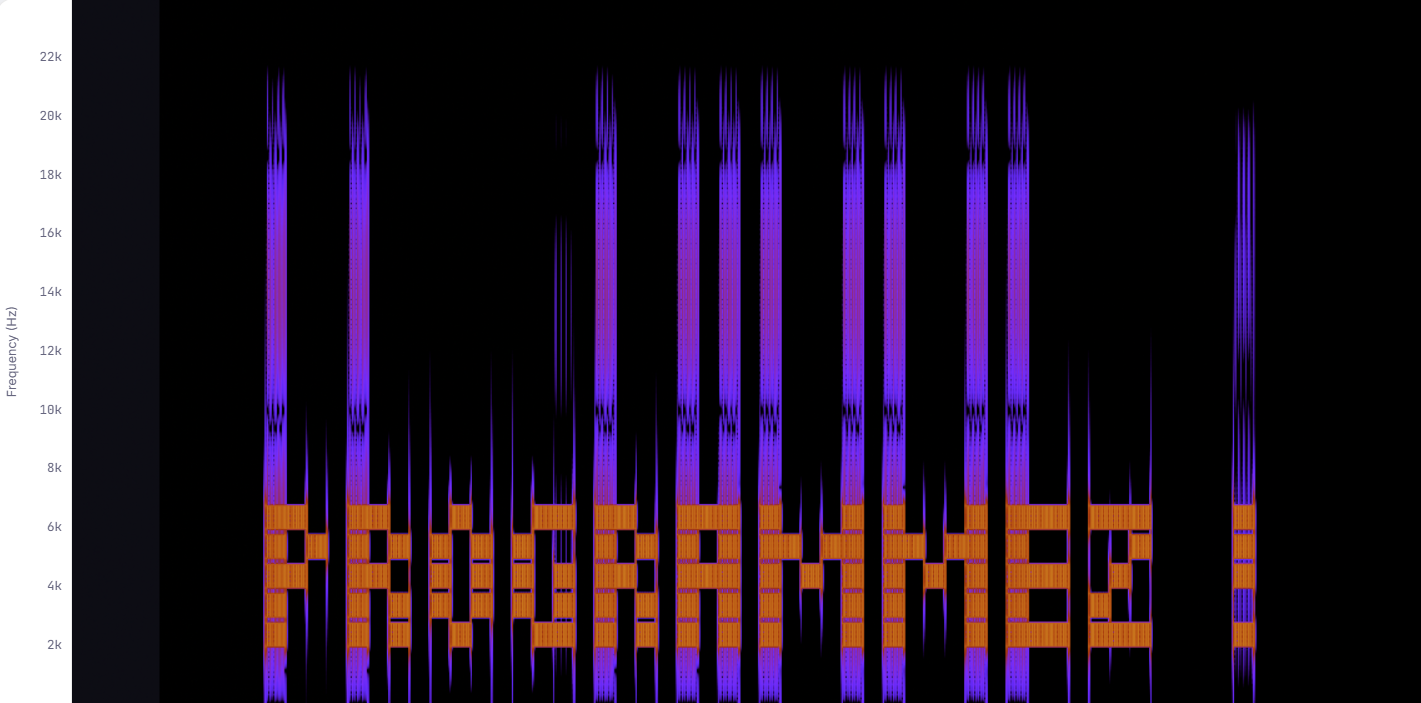
L’idée ici est simple : on l’a vu, un spectrogramme représente les fréquences dans le temps. Si on peut contrôler précisément quelles fréquences sont présentes à quel moment, on peut dessiner quelque chose dans le spectrogramme. Et si on mélange ça à un bruit de fond, le fichier audio reste banal à l’oreille, mais révèle son contenu à quiconque l’observe sur un spectrogramme.
Le principe de mon implémentation : je divise le spectre audible en bandes de fréquences correspondant aux lignes de pixels d’une police de caractères bitmap.
Chaque lettre est représentée par une série de colonnes de 5 pixels. Chaque pixel est soit allumé (1), soit éteint (0).
Chaque bande est alimentée par une vingtaine d’oscillateurs dont les fréquences sont réparties sur une plage d’environ 800 Hz, ce qui donne à chaque “pixel” une épaisseur visuelle suffisante pour être lisible sur le spectrogramme.
Ainsi fait, je peux obtenir un son dont le bruit ressemble à un grésillement sans intérêt, mais qui révèle son message sur un spectrogramme :
Merci d’avoir lu cet article jusqu’au bout !
Conférence
J’ai eu l’honneur de présenter une conférence à DevLille 2026, vous y trouverez sensiblement le même contenu que dans cet article, de manière plus racontée.
Remerciements
Merci à Tip Stevens d’avoir accepté que j’utilise l’une de ses musiques à des fins pédagogiques.
Sources
- https://www.ameli.fr/assure/sante/themes/acouphenes/definition-causes-consequences-acouphenes
- https://onlinetonegenerator.com/
- https://dutchaudioclassics.nl/The_cd_story/
- https://en.wikipedia.org/wiki/44,100_Hz
- https://www.dcode.fr/spectral-analysis
- https://www.youtube.com/watch?v=nMfPqeZjc2c
- https://en.wikipedia.org/wiki/Pure_tone
- https://en.wikipedia.org/wiki/Audio_frequency
- https://en.wikipedia.org/wiki/Nyquist%E2%80%93Shannon_sampling_theorem
- https://en.wikipedia.org/wiki/White_noise
- https://en.wikipedia.org/wiki/Fourier_transform
- https://en.wikipedia.org/wiki/Octave_band
- https://musiclab.chromeexperiments.com/spectrogram/
- https://academo.org/demos/spectrum-analyzer/
- https://fr.wikipedia.org/wiki/Bruit_rose
- https://en.wikipedia.org/wiki/Pink_noise